点击保存简历
模块
风格
模板
导入
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
陆明哲的照片
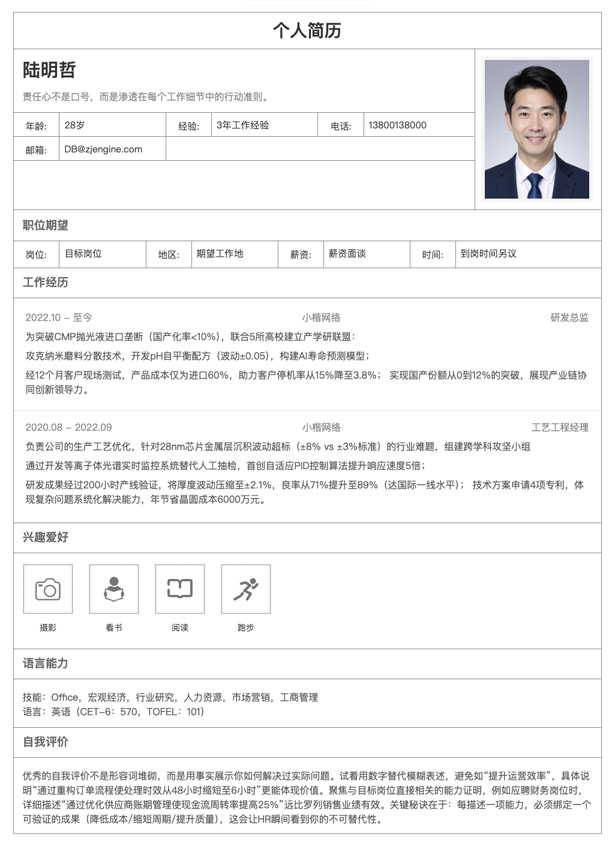
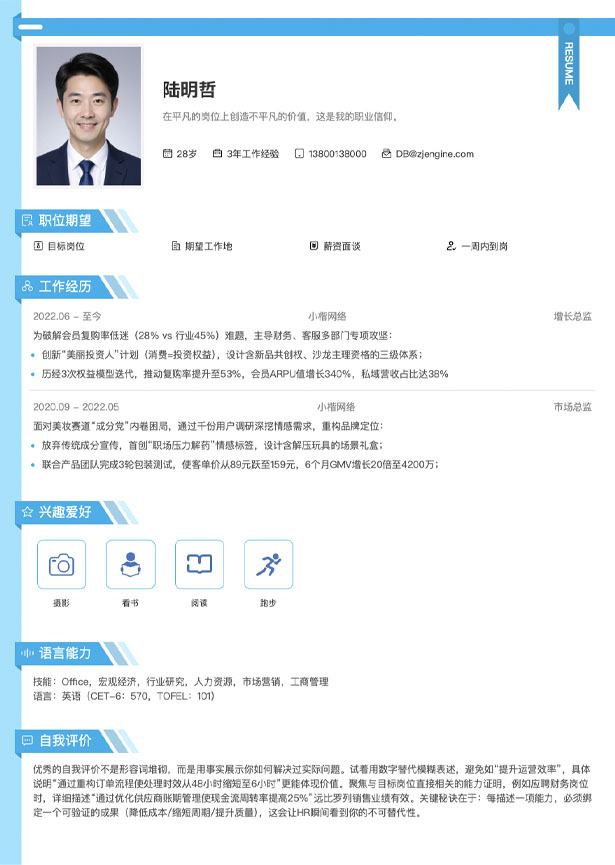
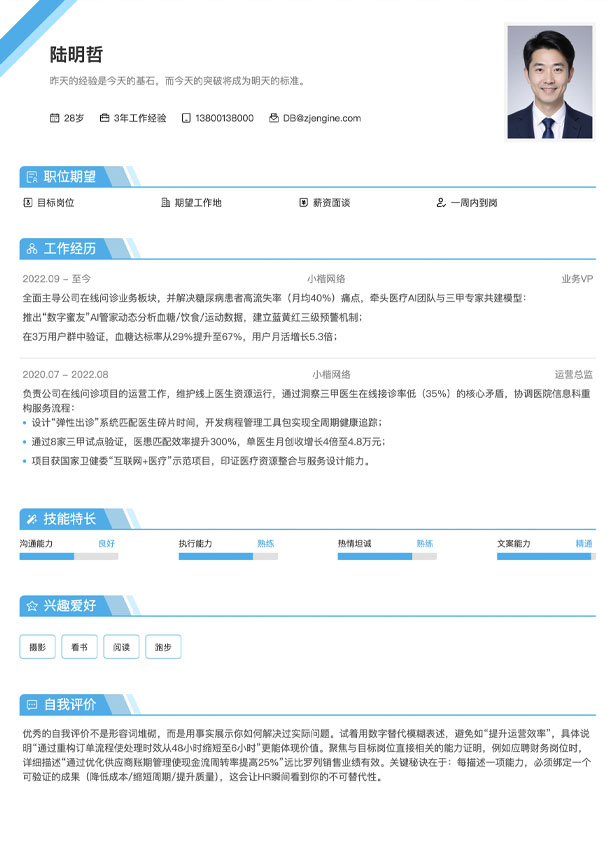
陆明哲
在平凡的岗位上创造不平凡的价值,这是我的职业信仰。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
云平台运维工程师
北京
薪资面谈
随时到岗
工作经历
2018.07 - 2020.02
小楷云枢科技有限公司
云平台运维工程师

负责公司公有云(阿里云、腾讯云)平台日常运维,涵盖资源调度、故障响应及基础自动化工具开发,保障电商促销、会员服务等核心业务系统的稳定性。

  • 主导日常云实例故障排查,通过ELK Stack聚合ECS、RDS日志,结合云监控指标定位高频CPU抖动问题根源为JVM内存泄漏,推动开发侧修复后,同类故障发生率下降78%,MTTR(平均修复时间)从45分钟压缩至15分钟。
  • 开发云资源自助申请系统,基于Python+Django框架对接阿里云API,实现VPC、ECS、SLB资源的可视化申请与自动交付,替代原人工审批流程,业务团队资源获取时效从2小时缩短至10分钟内,年节省人工操作超2000小时。
  • 搭建基础可观测体系,配置Prometheus采集EC2实例、Redis缓存、MQ消息队列的核心指标(CPU使用率、QPS、消息堆积量),并通过Grafana定制业务看板,关键指标告警准确率从75%提升至92%,漏报率下降60%。
2020.03 - 2022.06
小楷星环云计算有限公司
高级云平台运维工程师

统筹混合云(公有云+私有云OpenStack)架构运维,推动SRE(站点可靠性工程)体系建设,聚焦云资源成本优化与交付效率提升,支撑公司金融级交易系统迁移上云。

  • 主导混合云迁移项目,采用Terraform实现IaC(基础设施即代码),统一管理跨阿里云、OpenStack的200+资源栈,完成12个核心交易系统迁移,单系统部署耗时从72小时降至8小时,年度闲置云主机成本减少35%(约420万元)。
  • 设计云成本管控模型,通过AWS Cost Explorer结合自研Python脚本分析资源利用率,识别冗余RDS实例137台并降配,调整预留实例购买策略匹配业务周期,年度云总成本下降22%(约1800万元)。
  • 搭建SRE服务体系,制定关键业务SLO(服务等级目标)为99.95%可用性,拆解为CPU负载、数据库连接数等6项SLI(服务等级指标),建立错误预算消耗预警机制,Q4核心系统因运维操作导致的故障次数从8次降至0次。
  • 优化K8s集群弹性伸缩策略,基于Prometheus采集的Pod QPS、节点CPU负载指标,联动云厂商ASG(自动扩展组)动态调整节点数量,双11大促期间集群资源利用率从40%提升至75%,支撑10万+并发交易无压力。
2022.07 - 2025.06
小楷云图科技有限公司
云平台运维技术专家

负责公司云原生平台(K8s多集群、Serverless)全生命周期运维,保障跨北京、上海、广州三地业务高可用,推动运维向自动化、智能化转型,支撑AI训练、实时音视频等新兴业务上云。

  • 主导云原生平台升级,基于KubeSphere搭建多集群管理系统,集成Istio服务网格实现跨AZ流量智能调度,Q2某数据中心断电故障时,业务流量30秒内切换至备用集群,全年核心业务中断时长累计小于5分钟。
  • 设计混沌工程验证体系,使用Chaos Mesh在预发布环境注入网络延迟(500ms)、节点宕机(随机销毁30% Pod)等故障场景,发现Service Mesh路由规则缺陷并修复,关键服务容错能力(错误恢复率)从65%提升至95%。
  • 解决Serverless函数冷启动瓶颈,通过预置暖实例(提前30分钟加载高频函数)、资源预热策略(定时触发空请求),将平均冷启动时间从800ms降至200ms,支撑日活1000万+的直播弹幕推送服务零超时。
  • 落地AIOps智能运维,基于ELK+Prometheus的历史故障数据训练XGBoost异常检测模型,实现90%以上常见故障(如磁盘满、网络丢包)自动诊断并推送修复建议,运维人力投入减少30%,故障平均处理时长缩短至8分钟。
项目经验
2022.03 - 2023.08
星途互娱科技有限公司
运维开发负责人

混合云环境下智能运维平台重构项目

  • 项目背景:随着公司游戏业务全球化扩张,混合云(阿里云、腾讯云、AWS)资源规模突破10万+实例,原有运维平台存在跨云资源割裂、故障定位依赖人工、操作效率低等问题,导致核心游戏版本发布耗时超24小时,故障MTTR(平均修复时间)达45分钟。我的核心目标是主导重构平台,实现跨云资源统一管控与智能故障诊断,支撑业务快速迭代与稳定性保障。
  • 解决的关键难题与技术:一是跨云资源统一建模——不同云厂商API协议、资源属性差异大,数据同步延迟高;二是智能故障诊断——原有规则引擎仅覆盖30%常见故障,误报率达35%,无法识别复杂链路问题。针对前者,我设计了“抽象资源模型+云原生适配器”方案,将EC2、CVM、ECS等资源映射为统一的“计算/存储/网络”维度模型,通过自研云API网关实现协议转换(RESTful→gRPC),结合Kafka异步队列解决数据同步一致性问题;针对后者,我推动引入AIOps能力,收集metrics(Prometheus)、logs(ELK)、traces(Jaeger)多维度数据,训练“XGBoost+LSTM”混合模型,实现故障根因定位(RCA)与异常预测。
  • 核心行动与创新:牵头组建5人跨团队小组(云原生、算法、前端),历时6个月完成平台架构升级——底层采用微服务架构(Spring Cloud Alibaba),中间层封装跨云操作原子能力,上层提供“可视化管控+智能诊断”界面。创新点在于:1)轻量级机器学习推理框架集成,将模型推理延迟从1.2秒降至200ms,适配运维实时性要求;2)基于拓扑关系的故障传播链可视化,帮助运维人员快速理解故障影响范围。此外,我主导制定了《混合云运维操作规范》,将平台使用纳入团队SOP。
  • 项目成果与价值:平台上线后,跨云资源操作效率提升60%(单实例创建耗时从5分钟降至2分钟),故障MTTR缩短至8分钟,版本发布耗时压缩至12小时内。支撑了《星途纪元》全球多区域同步上线(覆盖15个国家和地区),期间未发生因运维问题导致的宕机。该平台成为公司混合云运维核心系统,节省年度运维人力成本约30%(约120万元)。我个人也因此晋升为运维开发团队负责人,负责后续平台迭代。
2020.06 - 2022.02
星途互娱科技有限公司
运维开发工程师

直播业务边缘节点自动化运维工具链研发项目

  • 项目背景:公司直播业务峰值并发超100万,边缘节点(覆盖全国31省CDN节点)从500个扩展至2000个,原有手动运维方式导致部署失败率高(75%)、故障处理滞后(30分钟内响应)。我的目标是构建边缘节点自动化运维工具链,实现“部署-监控-自愈”全流程闭环,保障直播低延迟与稳定性。
  • 解决的关键难题与技术:一是边缘节点网络不稳定,自动化部署成功率低;二是监控数据量大(单节点日均产生5GB日志),实时分析能力不足。针对前者,我基于Ansible Tower优化部署流程,开发自定义模块实现“断点续传+三次重试”机制,解决弱网环境下的包丢失问题;针对后者,采用Prometheus联邦采集边缘metrics,结合EdgeX Foundry搭建边缘数据 gateway,用Flink实现实时流处理(窗口聚合、异常检测),将数据处理延迟从10分钟降至1分钟。
  • 核心行动与创新:独立负责工具链需求调研与架构设计,梳理出“部署-配置-监控-故障处理”四大核心模块。创新点在于:1)轻量化边缘监控agent(体积<50MB),支持低资源环境运行;2)基于规则引擎+机器学习的故障自愈策略——常见故障(如进程重启、配置更新)自动处理,复杂故障触发告警并推送至移动端。此外,我编写了《边缘节点运维手册》,培训10名运维人员掌握工具使用。
  • 项目成果与价值:工具链上线后,边缘节点部署成功率提升至98%,故障处理时间缩短至5分钟内,直播卡顿率从8%降至2%。支撑了公司直播业务全年无重大故障,节省边缘运维人力成本约25%(约80万元)。该项目让我从“执行型运维”转向“方案设计型运维”,积累了边缘计算运维的核心经验,为后续混合云项目奠定了基础。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
奖项荣誉
  • 云计算运维工程师(中级)
  • 2023年度公司优秀员工
  • 2024年Q2项目攻坚奖
自我评价
  • 深耕互联网云平台运维,以「全链路风险预控」为核心,搭建资源-性能-故障传导的预警体系,习惯从业务影响倒推策略,替代被动救火。
  • 主导运维工具链从脚本到平台迭代,聚焦「减重复劳动、提响应速度」,坚信技术驱动是支撑业务高速迭代的基础。
  • 对云成本高度敏感,通过容量规划、闲置回收、实例适配降TCO,同时守住业务SLA,将每分云投入转化为业务价值。
  • 作为运维枢纽,能与研发、产品同频——懂业务痛点也讲清约束,推动问题从「各自解决」转向「共同预防」。
智能诊断
编写灵感
请选择需要查找的灵感类型
请选择灵感源泉
选择合适的内容插入后即可编辑调整
请在上方选择您需要获取的灵感类型
对话框
提示
说明