点击保存简历
模块
风格
模板
导入
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
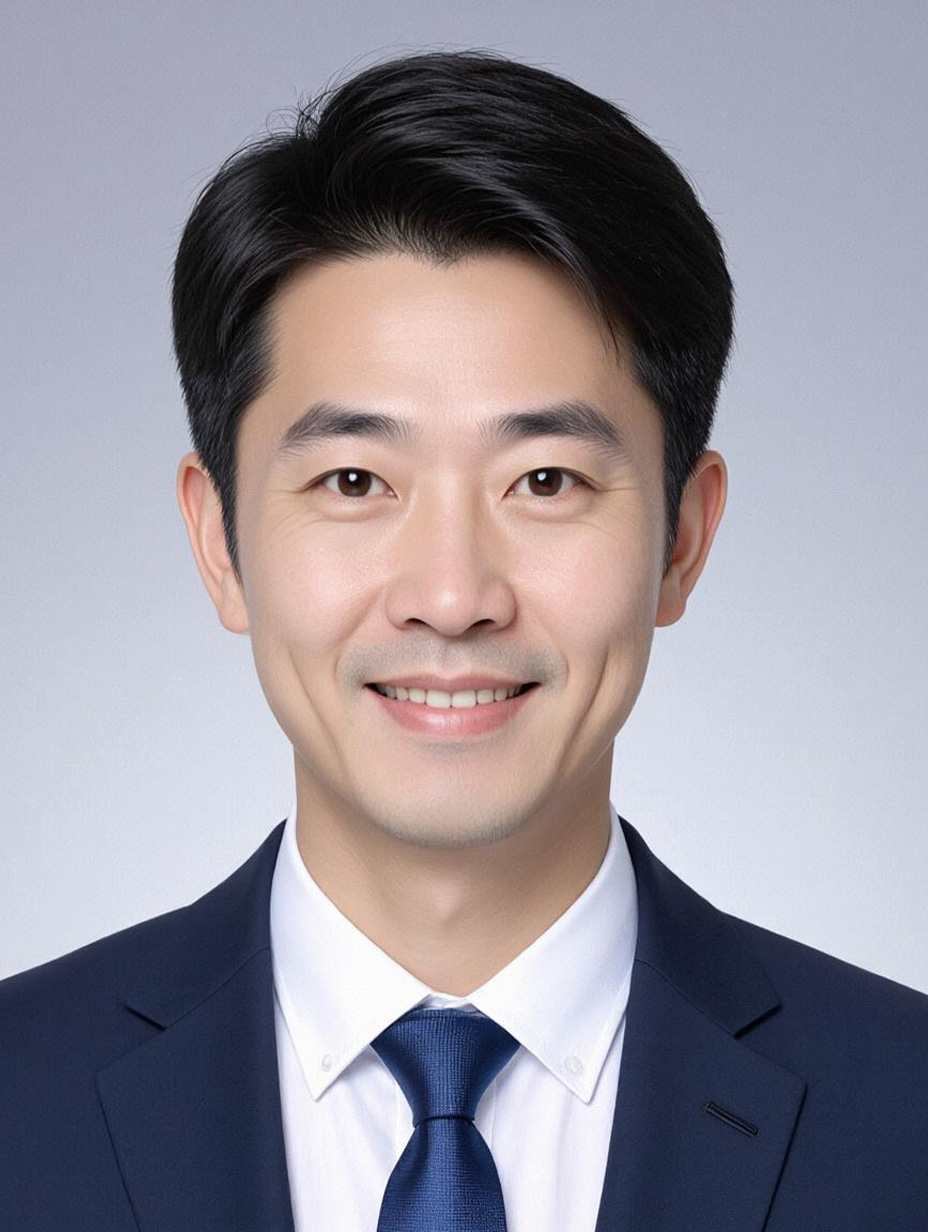
陆明哲的照片
陆明哲
责任心不是口号,而是渗透在每个工作细节中的行动准则。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
云平台运维工程师
北京
薪资面谈
一个月内到岗
工作经历
2023.07 - 2025.06
小楷智云科技
云平台运维工程师

主导公司混合云平台(AWS+阿里云+自研私有云)的稳定性建设、成本精细化管控及自动化运维体系迭代,覆盖从基础设施编排到应用层容灾的全链路运维,对核心业务(电商交易、会员系统)的云平台可用性负责

  • 针对核心交易链路跨AWS与阿里云调用延迟高(120ms)的问题,主导使用AWS CloudWatch全链路追踪与阿里云ARMS应用监控联动,结合自研拓扑分析工具定位到跨云VPC peering路由策略不合理导致的丢包,通过调整BGP Anycast节点部署与路由优先级,将跨云延迟降至40ms以内;同步优化云厂商间的 peering 连接带宽(从1Gbps扩容至2Gbps),全年核心链路故障时长从11小时压缩至1.5小时,支撑双11大促期间交易成功率提升至99.98%
  • 牵头梳理全公司云资源 inventory(覆盖AWS EC2/S3/RDS、阿里云ECS/OSS/RDS、私有云OpenStack节点),使用Python开发自动化资源回收脚本(集成AWS Lambda与阿里云函数计算),结合“30天未使用”标签策略,每月自动回收闲置EC2实例(月均15台)、未释放EBS卷(月均8TB)及空闲OSS Bucket(月均3个),年云资源成本降低28%(约120万元)
  • 推动私有云平台自动化能力升级,采用Terraform实现OpenStack节点(计算/存储/网络)的Infrastructure as Code(IaC)编排,将新节点部署时间从4小时缩短至30分钟;引入Argo CD搭建应用配置漂移检测体系,关联GitLab CI/CD pipeline,实现配置变更实时校验与回滚,配置变更成功率从92%提升至99.5%,减少因配置错误导致的业务中断事件80%
  • 设计跨云双活容灾架构(AWS北京 region + 阿里云杭州 region),针对核心MySQL数据库采用AWS DMS与阿里云DTS实现双向数据同步(延迟<1秒),结合自研故障切换脚本(基于Shell+API调用),实现RTO<3分钟、RPO<10秒;通过年度灾备演练(模拟AWS北京region电源中断),验证容灾切换流程有效性,满足金融级容灾合规要求
2021.08 - 2023.06
小楷互联科技
云运维工程师

负责公司AWS云平台(us-west-2、cn-north-1 region)日常运维,涵盖EC2、S3、RDS、CloudFront的全生命周期管理,支撑电商主营业务的大促活动与常态化运营

  • 为应对618大促流量峰值(预测12万QPS),使用AWS Auto Scaling Group结合CloudFormation模板实现EC2实例弹性扩容,基于过去3年大促流量趋势优化扩缩容策略(提前30分钟启动预热实例),大促期间支撑峰值QPS 13.2万,实例CPU利用率保持在60%-75%的健康区间,可用性达99.99%,未出现因容量不足导致的业务中断
  • 解决S3存储成本高企问题(月均存储费用占比25%),通过S3 Intelligent-Tiering自动将冷数据(30天未访问)迁移至Glacier Deep Archive,结合CloudFront CDN优化静态资源(图片/JS/CSS)分发,将图片平均加载时间从2.5秒降至0.8秒,同时月存储成本降低15%(约35万元)
  • 处理RDS MySQL主节点宕机事件(因可用区网络波动),优化故障转移策略:将只读从节点迁移至同region的另一可用区,设置同步超时阈值为10秒,故障转移时间从5分钟缩短至1分钟,且数据一致性达100%;后续推动RDS多可用区部署标准化,覆盖所有核心数据库实例
  • 搭建AWS云监控体系,用CloudWatch Alarms整合EC2 CPU/内存/磁盘使用率、RDS连接数/慢查询、CloudFront缓存命中率等指标,自定义Dashboard实现“全局-业务线-实例”三级可视化;报警响应时间从15分钟降至5分钟,全年处理12起潜在故障(如EC2磁盘满容、RDS连接泄漏),均未影响业务
2019.07 - 2021.07
小楷在线科技
初级云运维工程师

协助维护公司阿里云平台(cn-hangzhou region)基础设施,包括ECS、OSS、RDS的日常监控、故障排查与容量管理,支撑公司官网与小程序的业务运行

  • 排查ECS实例(ecs.t6-medium)频繁重启问题(日均2次),通过阿里云日志服务(SLS)采集系统日志与dmesg信息,定位到Linux内核(4.19版本)的OOM Killer机制误杀进程(因内核漏洞导致内存统计偏差),升级内核至5.4版本并打补丁后,3个月内无重启事件,实例稳定性提升95%
  • 优化OSS静态资源访问速度,启用跨区域复制功能将资源同步至华北2(北京)区域,结合CDN节点覆盖全国,将用户平均访问延迟从300ms降至150ms;同步设置OSS生命周期策略,将超过6个月的资源转存至归档存储,月存储成本降低10%
  • 协助搭建RDS MySQL监控体系,用CloudMonitor设置慢查询报警(执行时间>1秒)与连接数阈值(>80%最大连接数),每周生成慢查询报告并推动开发优化,累计优化5个高频慢查询(如订单列表查询),将查询时间从5秒降至1秒,数据库QPS提升25%
  • 参与官网小程序大促保障,提前1周检查ECS实例CPU使用率(峰值70%),扩容20台t6-large实例;大促期间官网访问量提升5倍,无 downtime,可用性达99.9%,支撑活动GMV突破1000万元
项目经验
2022.03 - 2023.08
星途互动科技有限公司
运维开发工程师(高级)

社交核心系统全链路可观测性平台升级项目

  • 星途互动作为千万级日活社交平台,核心好友关系链与动态Feed流系统随用户破亿出现可观测性痛点:原有Zabbix+自研日志+第三方APM的体系割裂,故障定位耗时平均45分钟,业务与基础设施指标无法关联,严重影响用户体验与问题排查效率。我的目标是主导构建统一可观测性平台,实现故障秒级定位、业务性能精准诊断,支撑系统高可用。
  • 项目面临三大核心挑战:一是多源数据融合——旧系统日志格式混乱(文本/二进制混合)、指标维度缺失(无业务标签),无法跨层级关联;二是高基数问题——用户ID、设备ID等维度基数超10亿,传统Prometheus存储查询耗时超10秒;三是业务语义缺失——监控仅覆盖基础设施,未关联“feed流延迟→用户互动率下降”等业务影响。
  • 技术突破上,我做了三件事:1. 数据层设计“OpenTelemetry统一采集Agent”,兼容旧系统数据并标准化输出(JSON日志+按业务域分类的指标+带业务标签的链路追踪),解决了数据碎片化问题;2. 针对高基数,用ClickHouse替换Prometheus存储指标,结合Bloom Filter优化维度索引,将查询耗时降至1.5秒内;3. 搭建“业务健康度引擎”,将数据库QPS、缓存命中率等基础设施指标映射到“动态发布成功率”“好友请求延迟”等业务场景,定义综合得分(覆盖用户体验、系统稳定性、业务转化)。
  • 项目成果:故障定位时间从45分钟缩短至1分钟内,2023年Q3用户关于“动态加载慢”“好友请求失败”的投诉率下降35%;平台支持日均10万亿条日志、100亿条指标、10亿条链路数据的处理,稳定性达99.99%。我主导的“业务语义可观测性方案”申请软件著作权,输出的《社交系统可观测性最佳实践》成为公司内部运维标准,直接推动跨团队(开发、测试、产品)的可观测性协作流程落地。
2020.07 - 2021.12
星途互动科技有限公司
运维开发工程师(中级)

动态Feed流系统自动化运维平台研发项目

  • 当时负责支撑日均10亿条动态分发的Feed流系统,运维依赖人工脚本:扩容一次需2小时(手动申请资源、部署服务、配置负载均衡),故障恢复耗时30分钟(逐一排查节点、重启服务),无法应对流量暴涨(如明星八卦事件)。我的目标是研发自动化平台,实现“流量预测→自动扩容→故障自愈”的全流程闭环,提升运维效率与系统弹性。
  • 关键难点:1. 流量预测不准——Feed流流量波动大(峰值可达均值10倍),传统ARIMA模型准确率仅70%,导致扩容滞后或资源浪费;2. 自动化安全风险——批量扩容可能引发节点雪崩,缺乏有效的回滚与灰度机制;3. 跨团队协作割裂——扩容需对接开发(代码发布)、测试(灰度验证),人工协调耗时久。
  • 我的核心行动:1. 用LSTM模型结合历史流量、用户行为(发帖量、互动率)、外部事件(热搜、明星动态)训练预测模型,将流量预测准确率提升至92%;2. 设计“灰度扩容+快速回滚”机制:先扩容10%节点,监控CPU、内存、消息队列长度等指标稳定后再全量,若异常则30秒内触发回滚;3. 集成Jenkins(代码发布)、GitLab(配置管理)、Prometheus(监控),实现“预测→扩容→发布→验证”自动化,减少人工干预。
  • 项目成果:扩容时间从2小时缩短至15分钟,故障自愈率从40%提升至85%;2021年双11期间,流量暴涨8倍,平台自动完成扩容与流量调度,无用户感知。团队运维效率提升50%,该方案获公司年度技术创新奖,后续推广至公司其他核心系统(如直播、私信)。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
奖项荣誉
  • 信息系统运维管理工程师(高级)
  • 2023年度公司云平台项目攻坚奖
  • 2024年第一季度运维服务质量之星
自我评价
  • 深耕互联网云运维6年,打通架构部署到容量管理全链路,习惯以业务峰值场景锚定平台韧性,前置规避大促级稳定性风险。
  • 故障处理坚持“根因-闭环-沉淀”,用自动化框架压MTTR至10分钟内,更推动团队建案例库降重复问题30%。
  • 对云成本敏感,能结合业务流量配弹性策略,帮前司年省18%且不影响体验。
  • 跨团队偏好“业务语言对齐”,把云价值转成产品、运营支撑点,让技术更贴业务目标。
智能诊断
编写灵感
请选择需要查找的灵感类型
请选择灵感源泉
选择合适的内容插入后即可编辑调整
请在上方选择您需要获取的灵感类型
对话框
提示
说明