点击保存简历
模块
风格
模板
导入
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
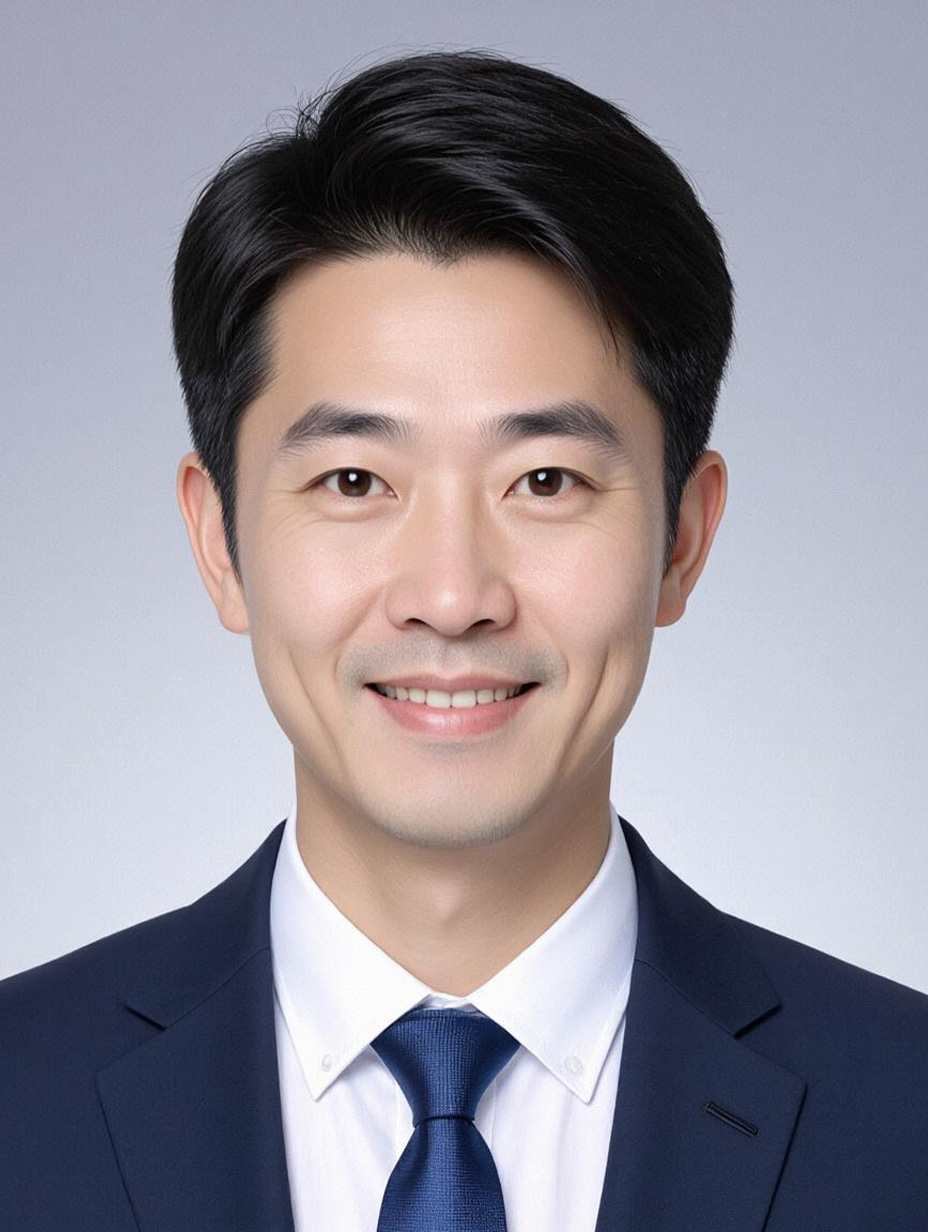
陆明哲的照片
陆明哲
在平凡的岗位上创造不平凡的价值,这是我的职业信仰。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
云平台运维工程师
北京
薪资面谈
三个月内到岗
工作经历
2022.07 - 2024.06
小楷云智科技有限公司
高级云平台运维工程师

负责公司混合云(阿里云+私有云)平台全生命周期运维,涵盖K8s集群管控、跨云资源编排、大促高可用保障及云成本优化,支撑电商业务峰值20万QPS的核心场景。

  • 主导设计混合云K8s集群架构,基于Terraform抽象跨云资源模型,开发自定义Provider解决阿里云ECS与私有云OpenStack实例参数差异问题,实现‘一套代码多云部署’;集群部署耗时从4小时压缩至45分钟,多环境配置不一致故障率下降60%。
  • 为应对双11流量洪峰,引入KubeFed实现跨AZ服务联邦调度,结合Prometheus自定义告警规则(覆盖节点负载、Pod驱逐风险等12类指标),并通过HPA+CA动态扩缩容;大促期间集群可用性达99.99%,较去年同期提升0.9个百分点,未发生因运维问题导致的业务中断。
  • 推动云成本深度优化,基于AWS Cost Explorer与阿里云账单分析,将70%的EC2实例从按需付费转为3年预留+Spot混合模式,同步落地Karpenter自动扩缩容工具;年度云成本降低35%(约280万元),同时通过优先级队列+快速重建机制将Spot实例中断导致的业务影响控制在0.1%以内。
  • 牵头搭建云原生可观测性平台,集成OpenTelemetry SDK采集指标/日志/链路数据,定制Grafana仪表盘覆盖商品详情、订单支付等90%核心链路;结合Thanos实现监控数据长期存储与聚合查询,故障定位时间从平均30分钟缩短至5分钟内,存储成本降低40%。
2020.08 - 2022.06
小楷互联科技有限公司
云运维工程师

负责公司私有云平台(基于OpenStack改造)日常运维,支撑内部OA系统、商家SaaS服务及测试环境,聚焦稳定性保障与自动化能力构建。

  • 核心参与‘OpenStack向K8s迁移’项目,制定分批次迁移策略(先非核心服务后交易类服务),使用Velero完成300+存量服务的无状态迁移,迁移后资源利用率从30%提升至60%,单服务运维人力投入减少50%;针对MySQL等有状态服务,开发Operator兼容旧存储卷挂载逻辑,确保业务零感知。
  • 构建自动化运维流水线,基于Ansible编写角色模板(含CentOS初始化、Nginx/Tomcat部署、防火墙配置),集成Jenkins实现‘代码提交-测试-上线’全流程自动化;故障恢复时间从2小时缩短至15分钟,人工操作失误率下降85%。
  • 优化监控体系,部署ELK Stack集中管理500+服务器日志,配置Logstash过滤规则提取‘支付超时’‘接口500错误’等业务关键词,结合Alertmanager设置分级告警(P0级5秒推送钉钉群);重要故障发现时效从1小时提升至2分钟内,客户投诉率下降25%。
2018.07 - 2020.07
小楷科技有限公司
系统运维工程师

负责公司物理机与VMware虚拟化平台运维,保障研发测试环境及生产系统稳定,积累基础运维与问题排查经验。

  • 主导搭建VMware vSphere虚拟化平台,规划8节点ESXi集群、vSAN分布式存储及VRRP网络策略,支撑500+虚拟机运行;通过HA(高可用)与DRS(动态资源调度)配置,年故障停机时间少于2小时,达到SLA 99.95%要求。
  • 开发Python脚本自动化创建虚拟机模板(预装CentOS+GitLab+Jenkins),并集成到自研运维平台;测试环境交付周期从3天缩短至4小时,研发团队迭代效率提升30%。
  • 建立容量管理机制,每周分析CPU/内存/存储使用趋势,结合业务上线计划预测资源需求;提前3个月完成服务器扩容,生产环境资源冗余率从40%降低至15%,年硬件采购成本节省约80万元。
项目经验
2022.03 - 2023.08
星途互娱科技有限公司
运维开发负责人

混合云环境下智能运维平台重构项目

  • 项目背景:随着公司游戏业务全球化扩张,混合云(阿里云、腾讯云、AWS)资源规模突破10万+实例,原有运维平台存在跨云资源割裂、故障定位依赖人工、操作效率低等问题,导致核心游戏版本发布耗时超24小时,故障MTTR(平均修复时间)达45分钟。我的核心目标是主导重构平台,实现跨云资源统一管控与智能故障诊断,支撑业务快速迭代与稳定性保障。
  • 解决的关键难题与技术:一是跨云资源统一建模——不同云厂商API协议、资源属性差异大,数据同步延迟高;二是智能故障诊断——原有规则引擎仅覆盖30%常见故障,误报率达35%,无法识别复杂链路问题。针对前者,我设计了“抽象资源模型+云原生适配器”方案,将EC2、CVM、ECS等资源映射为统一的“计算/存储/网络”维度模型,通过自研云API网关实现协议转换(RESTful→gRPC),结合Kafka异步队列解决数据同步一致性问题;针对后者,我推动引入AIOps能力,收集metrics(Prometheus)、logs(ELK)、traces(Jaeger)多维度数据,训练“XGBoost+LSTM”混合模型,实现故障根因定位(RCA)与异常预测。
  • 核心行动与创新:牵头组建5人跨团队小组(云原生、算法、前端),历时6个月完成平台架构升级——底层采用微服务架构(Spring Cloud Alibaba),中间层封装跨云操作原子能力,上层提供“可视化管控+智能诊断”界面。创新点在于:1)轻量级机器学习推理框架集成,将模型推理延迟从1.2秒降至200ms,适配运维实时性要求;2)基于拓扑关系的故障传播链可视化,帮助运维人员快速理解故障影响范围。此外,我主导制定了《混合云运维操作规范》,将平台使用纳入团队SOP。
  • 项目成果与价值:平台上线后,跨云资源操作效率提升60%(单实例创建耗时从5分钟降至2分钟),故障MTTR缩短至8分钟,版本发布耗时压缩至12小时内。支撑了《星途纪元》全球多区域同步上线(覆盖15个国家和地区),期间未发生因运维问题导致的宕机。该平台成为公司混合云运维核心系统,节省年度运维人力成本约30%(约120万元)。我个人也因此晋升为运维开发团队负责人,负责后续平台迭代。
2020.06 - 2022.02
星途互娱科技有限公司
运维开发工程师

直播业务边缘节点自动化运维工具链研发项目

  • 项目背景:公司直播业务峰值并发超100万,边缘节点(覆盖全国31省CDN节点)从500个扩展至2000个,原有手动运维方式导致部署失败率高(75%)、故障处理滞后(30分钟内响应)。我的目标是构建边缘节点自动化运维工具链,实现“部署-监控-自愈”全流程闭环,保障直播低延迟与稳定性。
  • 解决的关键难题与技术:一是边缘节点网络不稳定,自动化部署成功率低;二是监控数据量大(单节点日均产生5GB日志),实时分析能力不足。针对前者,我基于Ansible Tower优化部署流程,开发自定义模块实现“断点续传+三次重试”机制,解决弱网环境下的包丢失问题;针对后者,采用Prometheus联邦采集边缘metrics,结合EdgeX Foundry搭建边缘数据 gateway,用Flink实现实时流处理(窗口聚合、异常检测),将数据处理延迟从10分钟降至1分钟。
  • 核心行动与创新:独立负责工具链需求调研与架构设计,梳理出“部署-配置-监控-故障处理”四大核心模块。创新点在于:1)轻量化边缘监控agent(体积<50MB),支持低资源环境运行;2)基于规则引擎+机器学习的故障自愈策略——常见故障(如进程重启、配置更新)自动处理,复杂故障触发告警并推送至移动端。此外,我编写了《边缘节点运维手册》,培训10名运维人员掌握工具使用。
  • 项目成果与价值:工具链上线后,边缘节点部署成功率提升至98%,故障处理时间缩短至5分钟内,直播卡顿率从8%降至2%。支撑了公司直播业务全年无重大故障,节省边缘运维人力成本约25%(约80万元)。该项目让我从“执行型运维”转向“方案设计型运维”,积累了边缘计算运维的核心经验,为后续混合云项目奠定了基础。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
奖项荣誉
  • 信息系统运维管理工程师(中级)
  • 2022年度公司项目攻坚奖
  • 2023年度部门优秀技术员工
自我评价
  • 深耕互联网云平台运维,以「全链路风险预控」为核心,搭建资源-性能-故障传导的预警体系,习惯从业务影响倒推策略,替代被动救火。
  • 主导运维工具链从脚本到平台迭代,聚焦「减重复劳动、提响应速度」,坚信技术驱动是支撑业务高速迭代的基础。
  • 对云成本高度敏感,通过容量规划、闲置回收、实例适配降TCO,同时守住业务SLA,将每分云投入转化为业务价值。
  • 作为运维枢纽,能与研发、产品同频——懂业务痛点也讲清约束,推动问题从「各自解决」转向「共同预防」。
智能诊断
编写灵感
请选择需要查找的灵感类型
请选择灵感源泉
选择合适的内容插入后即可编辑调整
请在上方选择您需要获取的灵感类型
对话框
提示
说明