点击保存简历
模块
风格
模板
导入
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
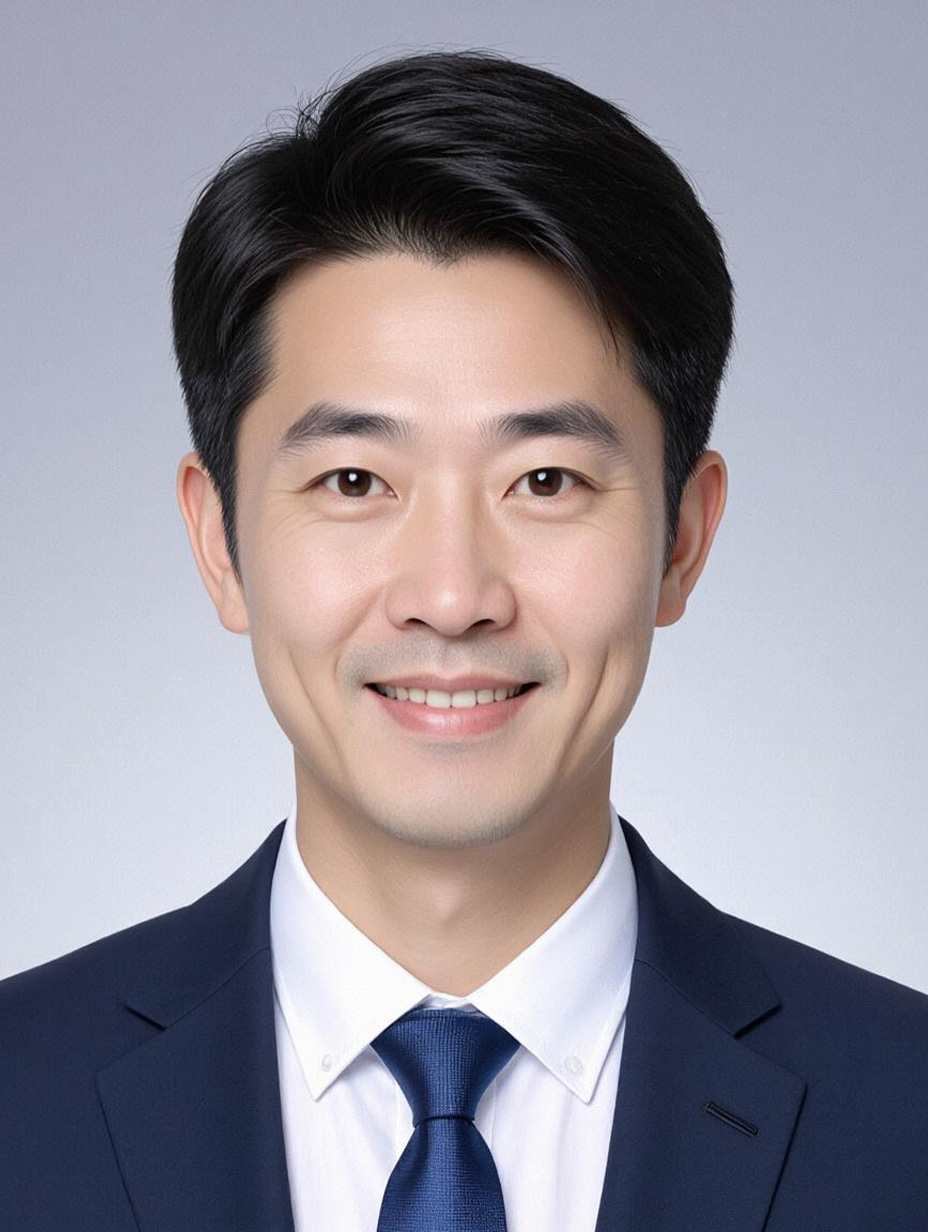
陆明哲的照片
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
云平台运维工程师
北京
薪资面谈
随时到岗
技能特长
沟通能力
执行能力
热情坦诚
文案能力
兴趣爱好
摄影
看书
阅读
跑步
陆明哲
在平凡的岗位上创造不平凡的价值,这是我的职业信仰。
工作经历
2023.07 - 2025.06
小楷智云
云平台运维工程师

负责公司公有云(阿里云、腾讯云)与私有云(OpenStack)混合架构全生命周期运维,主导自动化运维体系搭建、容量规划及99.99% SLA保障,支撑电商大促、金融交易等核心业务稳定运行。

  • 主导设计混合云资源管理平台,基于Terraform实现IaC(基础设施即代码)标准化,结合Ansible完成2000+云资源(ECS、CLB、RDS)的自动化编排与配置校验,解决多环境(开发/测试/生产)配置漂移问题,资源交付周期从48小时压缩至2小时,资源利用率从42%提升至77%(通过云厂商账单分析与资源水位监控验证)。
  • 搭建Prometheus+Grafana全链路监控体系,集成云厂商API、Kubernetes Metrics Server及自定义业务指标(如订单成功率、支付耗时),设计分级告警规则(P0-P4)并对接企业微信/电话告警,Q2季度故障定位时间从25分钟缩短至8分钟,全年因云平台问题导致的P0级故障次数同比下降60%(对比2023年同期数据)。
  • 推动Kubernetes集群性能优化,针对双11流量峰值(较日常5倍)场景,调整调度策略(引入节点亲和性、污点容忍度)并启用Cluster Autoscaler动态扩缩容,配合HPA基于QPS自动调整Pod副本数,集群CPU平均利用率从35%提升至68%,支撑单日1.2亿订单交易无超时报错,稳定性达99.995%。
  • 牵头容量规划项目,通过分析近12个月业务增长曲线(DAU月均增15%)与云资源消耗模型,预测2024年Q4需扩容300台ECS实例及50TB块存储,提前协调云厂商预留资源并优化采购策略(混合使用按需实例与抢占式实例),较原预算节省28%(约450万元)。
2021.08 - 2023.06
小楷互联
高级云平台运维工程师

负责公司核心业务云平台(AWS、华为云)高可用架构设计与运维,主导跨云容灾方案落地及年度成本优化,保障金融级业务99.99%可用性与成本可控。

  • 主导AWS中国区向华为云迁移项目,采用CloudEndure实现200+业务实例(含MySQL、Redis)的增量同步,结合自定义Python脚本完成网络配置(VPC peering、安全组规则)迁移,迁移窗口期业务中断时间控制在15分钟内,迁移后资源成本降低22%(月均节省120万元),SLA从99.9%提升至99.95%(通过第三方拨测验证)。
  • 构建FinOps成本管控体系,基于AWS Cost Explorer与自研账单分析工具(Go语言开发),识别冗余EC2实例(占比18%)与S3冷数据(占比30%),推动开发团队优化Docker镜像(平均体积从2GB缩减至1.2GB)及调整存储类型(高频数据转低频访问),年度云成本节省180万元,成本优化率15%(写入公司年度降本报告)。
  • 优化云安全防护体系,部署阿里云WAF+威胁情报平台,定制120条安全规则拦截SQL注入、XSS攻击,结合云防火墙封禁恶意IP段(日均阻断攻击尝试5万+次),全年未发生因云安全漏洞导致的业务中断,安全事件数量同比下降75%(对比2021年)。
  • 设计跨云容灾方案,通过华为云DRS实现MySQL主从实时同步,定期执行故障切换演练(季度级),验证RPO≤5分钟、RTO≤30分钟,满足金融行业监管要求(通过等保三级测评)。
2019.07 - 2021.07
小楷在线
云平台运维工程师

负责公司初期云平台(阿里云)基础运维,保障测试/生产环境稳定,参与自动化工具链搭建,支撑电商业务从0到1落地。

  • 搭建阿里云ECS+RDS+OSS基础架构,编写Shell脚本实现每日数据库全量+增量备份(保留7天)及OSS日志自动转冷(30天后转归档存储),全年数据丢失风险为0,存储成本降低30%(对比人工管理时期)。
  • 推动测试环境容器化改造,基于Docker Compose+Jenkins实现测试环境快速创建(4小时内完成从0到N套环境部署),替代传统虚拟机(单环境创建需1天),团队研发迭代效率提升25%(PMO统计)。
  • 建立云平台操作规范,制定《云资源申请审批SOP》(含资源命名、标签规范)与《云故障应急手册》(覆盖ECS宕机、RDS主备切换等场景),组织季度应急演练,人为操作失误导致的故障次数从每月3次降至0.5次以内。
  • 优化日志分析流程,部署ELK Stack(Elasticsearch+Logstash+Kibana)收集应用日志与云审计日志,通过Kibana仪表盘监控接口错误率(目标<0.1%),Q4季度接口异常发现时效从2小时缩短至5分钟,助力业务故障修复效率提升40%。
项目经验
2022.07 - 2024.03
星途互动科技有限公司
运维开发工程师(资深)

电商大促高可用保障体系全链路升级项目

  • 项目背景:公司核心电商平台承载年GMV超100亿的业务,过往大促(如双11、618)依赖人工巡检与被动故障响应,SLA仅99.5%,曾因数据库慢查询、缓存击穿导致页面宕机3次,影响订单转化率。目标是构建“预防-监控-处置”全链路自动化保障体系,将大促SLA提升至99.95%以上。
  • 关键难题:1)多系统(订单、库存、支付、物流)耦合下,故障根因定位耗时平均15分钟;2)流量峰值(单秒10万QPS)下,资源弹性伸缩滞后,曾出现库存服务CPU飙升至90%未及时扩容;3)跨团队(开发、测试、运维)预案协同混乱,故障处置时职责不清。
  • 核心行动:1)主导基于Jaeger的全链路追踪平台建设,整合12个核心系统的trace数据,通过自定义标签(如订单ID、用户地域)实现故障秒级溯源,定位时间缩短至2分钟内;2)设计“历史流量+实时舆情”的动态容量预测模型(用Python实现LSTM算法),预测准确率达92%,联动阿里云弹性伸缩规则,将资源扩容时间从30分钟压缩至5分钟;3)开发混沌演练平台,覆盖“网络延迟、节点宕机、数据库主从切换”8类高频故障场景,推动制定《大促故障处置SOP》,并将跨团队演练频率从季度改为月度,协同效率提升40%。
  • 项目成果:大促期间SLA稳定在99.95%以上,故障响应时间从15分钟降至2分钟,年度因故障导致的订单损失减少约800万元;资源弹性成本降低18%(年节省云费用120万)。本人主导了全链路体系的架构设计与落地,推动跨部门建立了标准化的故障处置流程,成为公司大促保障的核心技术负责人。
2020.05 - 2022.06
星途互动科技有限公司
高级运维开发工程师

容器化微服务治理平台自主研发项目

  • 项目背景:公司微服务数量从20个增长至50+,依赖第三方容器平台(如某云ACK)不仅年费用超300万,且缺乏针对业务的流量治理、资源调度能力(如活动服务需优先分配资源)。目标是自主研发轻量化容器治理平台,支撑微服务高可用与成本优化。
  • 关键难题:1)第三方平台无法实现“按业务优先级”的资源抢占,活动高峰期常因资源竞争导致核心服务延迟;2)微服务间流量调度单一,无法支持灰度发布时的按用户分层放量;3)平台扩展性差,新增微服务需手动配置监控与熔断规则。
  • 核心行动:1)基于Kubernetes Operator模式开发“业务优先级调度模块”,通过自定义ResourceQuota与PriorityClass,实现活动服务在大促时自动抢占非核心服务资源,资源利用率从45%提升至65%;2)集成Istio服务网格,设计“用户标签+权重”的灰度发布策略,支持按新用户/老用户、地域分层放量,将灰度故障影响范围缩小至5%以内;3)构建自动化规则引擎,通过Prometheus采集的指标(如QPS、延迟)自动生成熔断与降级策略,无需人工干预,微服务故障次数减少50%。
  • 项目成果:平台上线后替代了第三方容器平台的核心功能,年节省费用300万;微服务平均延迟从80ms降至50ms,故障恢复时间从30分钟缩短至5分钟;平台可用性达99.99%,支持公司微服务数量扩张至80+。本人主导了平台的核心模块研发与架构设计,解决了微服务治理的关键痛点,推动公司技术栈从“依赖第三方”转向“自主可控”。
教育背景
2013.09 - 2016.06
XX美术附属中学
艺术特长班
通过每日速写训练(累计500+小时),夯实视觉表达基本功;作品《城市记忆》系列入选省级青年艺术展,验证用户情感共鸣设计能力,被XX美术馆收藏。
2016.09 - 2020.06
XX艺术学院
视觉传达设计(本科)
主攻品牌视觉系统课程(专业排名前10%),建立商业设计与用户行为关联模型;为XX茶饮品牌设计的“国风年轻化”视觉方案,助力客户线下店开业首月业绩提升35%,方案入选《中国新锐设计年鉴》。Adobe创意设计大赛全国一等奖。
奖项荣誉
  • 信息系统运行维护员(高级)职业技能等级证书
  • 阿里云ACP云计算工程师认证
  • 2022年度公司项目攻坚奖
自我评价
  • 深耕互联网云运维,以业务连续性为核心搭高可用体系,习惯从用户端体验反推策略,提前布局容灾弹性,避免被动救火。
  • 擅长数据驱动资源优化,从利用率到成本形成闭环,锚定业务增长平衡性能投入,让云资源支撑更多核心场景。
  • 故障处理不止恢复,更沉淀根因分析与流程改进机制,推动跨团队建故障预防共识,把单点问题转组织能力迭代。
  • 跨团队用业务语言解码技术约束,让产品开发快速理解运维边界,共定支撑业务目标的方案,降沟通成本。
智能诊断
编写灵感
请选择需要查找的灵感类型
请选择灵感源泉
选择合适的内容插入后即可编辑调整
请在上方选择您需要获取的灵感类型
对话框
提示
说明