当前模板已根据「数据平台开发工程师」岗位深度优化
选择其他岗位
开始编辑模板后,您可以进一步自定义包括:工作履历、工作内容、信息模块、颜色配置等
内置经深度优化的履历,将为你撰写个人简历带来更多灵感。
陆明哲
用系统化的思维解决问题,用温度化的方式交付成果,这是我的工作准则。
28岁
3年工作经验
13800138000
DB@zjengine.com
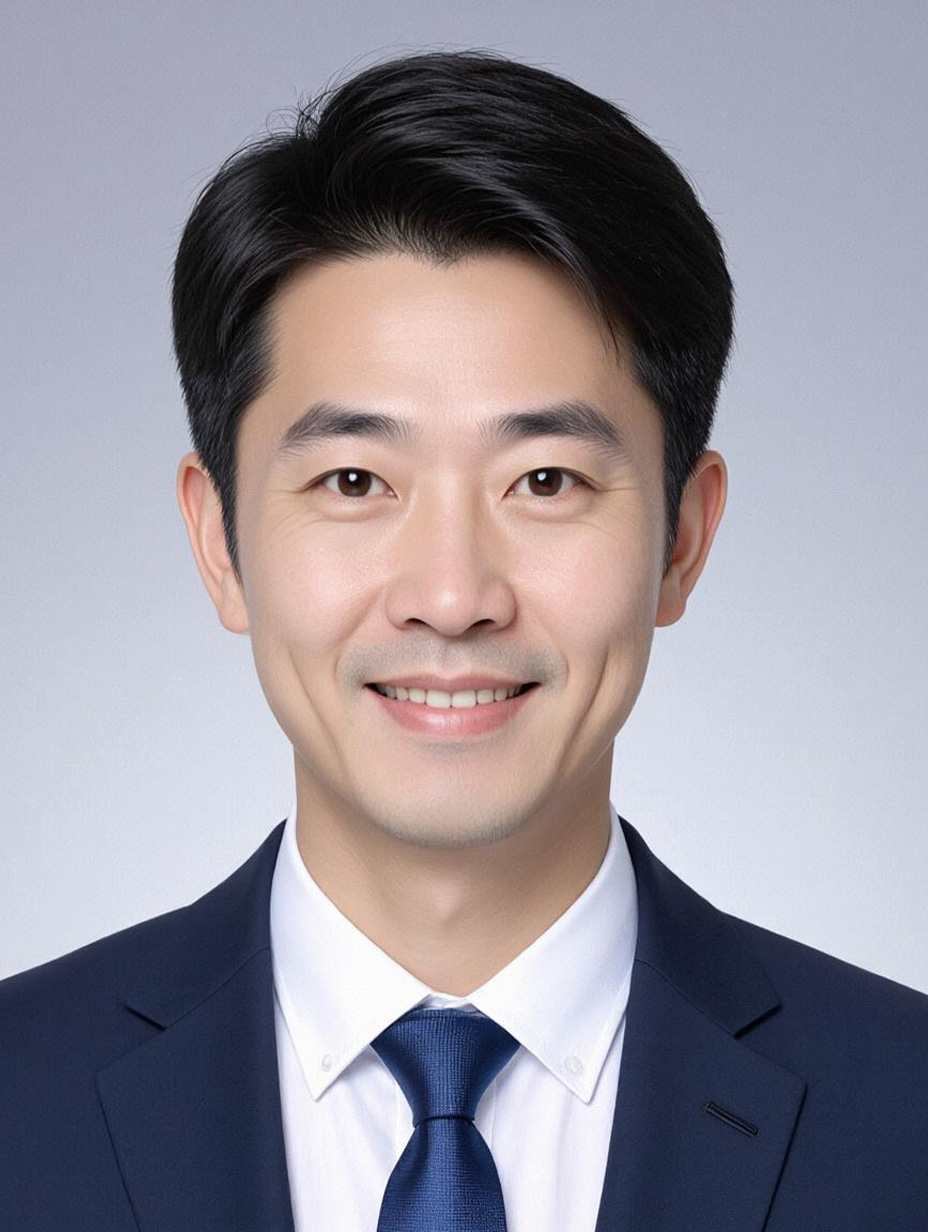
陆明哲的照片
求职意向
数据平台开发工程师
苏州
薪资面谈
一个月内到岗
工作经历
2022.07 - 2024.06
小楷科技
资深数据平台开发工程师

负责公司级数据平台的架构设计、核心模块开发与性能优化,支撑电商、金融多业务线的数据接入、湖仓一体处理及对外API服务,聚焦高并发查询、细粒度权限与生态整合的关键能力落地

  • 主导设计基于Apache Doris的实时数据湖仓一体模块,针对原有Hadoop+ClickHouse架构下数据同步延迟高(平均15分钟)、并发查询瓶颈(峰值QPS 800)的问题,采用Flink CDC捕获MySQL/Oracle binlog,结合Doris的Range分区、Rollup预聚合与物化视图优化,将数据同步延迟压降至1分钟内,并发查询能力提升至2400 QPS,直接支撑了双11期间实时GMV看板、用户复购分析等核心场景的需求
  • 核心重构数据平台权限管理系统,基于Apache Ranger自定义Policy引擎,整合Spring Security实现表级、列级、行级细粒度权限控制,同时将权限操作日志与访问日志异步写入Elasticsearch,解决原有系统仅支持库级权限、缺乏审计能力的问题。上线后权限审批流程从人工核对转为自动化校验,效率提升60%,全年拦截越权访问尝试1200+次,未发生数据泄露事件
  • 优化数据平台Airflow任务调度系统,针对高并发场景下任务排队延迟(峰值20分钟)、失败率高(8%)的问题,引入Celery分布式队列承载任务触发逻辑,结合Redis缓存任务元数据减少数据库压力,同时调整任务分片策略为按业务线隔离,将日均10万+任务的调度延迟降至5分钟内,任务成功率提升至99.2%
  • 推动数据平台与机器学习平台生态整合,基于Kafka Connect构建实时特征Pipeline,将用户点击、浏览行为数据实时同步至MLflow特征Store,解决原有离线特征同步T+1延迟无法支撑实时推荐模型的问题。整合后模型特征更新频率从1天1次提升至5分钟1次,推荐系统AUC从0.82提升至0.841,线上CTR增长3.5%
2020.08 - 2022.06
小楷数联
数据平台开发工程师

负责数据平台核心组件(ETL调度、数据仓库、元数据管理)的开发与维护,支撑内容、教育业务线的离线数据处理需求,参与平台性能瓶颈分析与功能迭代

  • 主导开发数据平台可视化ETL配置模块,基于Airflow自定义Python Operator与Vue前端交互,实现跨MySQL、Hive、OSS数据源的增量/全量同步任务配置。针对原有任务依赖靠代码编写的痛点,设计拖拽式依赖关系界面,将任务配置时间从2小时缩短至30分钟,任务失败率从8%降至2%,累计支持10+业务线快速接入
  • 参与用户行为数据仓库分层设计(ODS→DWD→DWS→ADS),基于Hive 3.x与Spark SQL完成100+张主题表的搭建,定义统一的数据规范(如用户ID脱敏规则、时间戳格式)。通过优化Spark shuffle分区数(从200调整至500)与内存参数(executor-memory从4G增至8G),将DWD层日活用户行为数据的处理时间从4小时降至1.5小时,支撑运营团队每日早会的数据决策需求
  • 搭建基于Apache Atlas的元数据管理系统,实现数据血缘自动采集(覆盖Hive、Spark、Flink作业)与可视化展示。针对原有数据问题定位需人工查代码的痛点,开发数据质量规则引擎,设置空值率、唯一性、字段一致性等100+条规则,数据质量问题发现时间从24小时缩短至1小时内,数据可用率从92%提升至98%
2018.07 - 2020.07
小楷云智
大数据开发工程师

负责公司大数据平台的基础搭建与日常维护,支撑内部管理系统的离线数据需求,参与Hadoop生态组件的部署与性能优化

  • 参与公司Hadoop集群初始搭建(HDFS 3.2、YARN 3.2、Hive 2.3),优化集群配置:将NameNode从单节点改为ZooKeeper HA模式,调整YARN的资源调度器为Capacity Scheduler并按业务线划分队列,将集群存储利用率从40%提升至70%,计算资源利用率从30%提升至60%,满足初期业务增长的数据存储与计算需求
  • 开发离线数据报表模块,基于Hive SQL与Tableau实现用户留存率、订单转化率、渠道ROI等10+核心指标的可视化。针对原有报表计算慢(30分钟/张)的问题,优化SQL逻辑(如避免笛卡尔积、使用分区裁剪、缓存中间表),将报表生成时间缩短至5分钟,支撑管理层每周的经营分析会议
  • 保障集群稳定性,全年处理HDFS坏块、YARN节点宕机等故障20+次。开发数据备份脚本(基于Sqoop同步关键表至备份HDFS集群),将数据恢复时间从8小时缩短至2小时,确保业务数据零丢失
项目经验
2022.03 - 2023.08
星途互娱(专注泛娱乐内容生态的互联网平台,旗下覆盖短视频、直播、游戏三大核心业务)
大数据开发负责人

星途互娱用户行为实时数仓及个性化推荐支撑平台建设

  • 项目背景:公司短视频、直播业务月活突破5000万时,原有离线数仓(Hive+MySQL)无法满足实时推荐、活动运营的即时数据需求——实时推荐延迟超5分钟,活动效果报表需T+1产出,导致用户体验下滑、运营决策滞后。我的核心目标是搭建一套低延迟、高一致性的实时数仓体系,支撑推荐系统秒级数据供给及运营实时监控,同时保障数据可扩展性。
  • 关键难题与技术选型:①多源数据整合:APP、小程序、微信/支付宝支付网关的数据格式异构,增量同步易丢包;②低延迟与一致性平衡:原有Spark Streaming任务延迟高且无法保证Exactly Once,推荐数据常重复或丢失;③资源调度冲突:实时任务抢占离线资源,频繁导致任务积压。针对这些问题,我选用Flink作为实时计算引擎(支持毫秒级延迟与Exactly Once语义),用Kafka做统一消息队列承接增量数据;通过Canal同步MySQL业务库的变更日志到Kafka,再由Flink解析并关联用户行为数据;设计“实时ODS-DWD-DWS-ADS”四层架构,O层存原始事件,DWD做维度关联(用户-视频-主播),DWS聚合实时指标(如用户10分钟内互动频次),ADS输出推荐特征与运营报表。
  • 核心行动与创新:主导完成架构设计与《实时数据处理规范》输出,对齐数据产品、算法团队需求;优化Flink资源配置——采用YARN队列隔离实时与离线资源,结合动态扩缩容策略(根据Kafka Partition数自动调整TaskManager数量),将任务延迟从5分钟压至10秒内;针对“用户行为计数”类任务,提出“随机前缀+两阶段聚合”方案(先局部聚合再全局汇总),解决数据倾斜问题,任务运行时间缩短40%;协调算法团队校准推荐特征口径,确保实时特征与离线模型兼容。
  • 项目成果:平台支撑了公司3条核心业务的实时推荐与运营,实时推荐点击率从1.8%提升至2.3%(+28%),活动转化率提升15%;实时数仓复用率达80%,节省后续项目底层开发成本超200万元;我主导的“实时数据一致性方案”被纳入公司大数据技术标准,成为后续实时项目的参考模板。
2020.07 - 2022.02
星途互娱
大数据开发工程师(核心成员)

星途互娱会员生命周期管理数据平台建设

  • 项目背景:公司会员体系存在“数据分散、标签模糊、运营粗放”痛点——会员数据散落在注册、消费、互动系统,字段不统一;运营无法精准识别“潜在/流失会员”,营销活动ROI仅1.2(行业平均1.5)。我的目标是整合全链路数据,搭建生命周期数据平台,支撑精准分层运营,提升会员价值。
  • 关键难题与技术方案:①ID-Mapping:各系统会员标识不统一(注册用手机号、消费用用户ID),需打通跨系统数据;②模型落地:传统RFM模型未结合互动行为(评论、分享),生命周期划分不准确;③实时性:运营需要实时查看标签变化,原有Spark Daily批量计算无法满足。解决方案:用Spark做批量处理,通过Redis-based ID-Mapping工具统一会员ID;重新设计标签体系——包含基础属性、价值属性、行为属性、生命周期阶段(潜在/成长/成熟/流失);基于改进RFM模型(加入互动行为权重)结合K-means聚类,实现生命周期自动化划分。
  • 核心行动与决策:主导梳理12个业务系统的会员数据字典,完成ID-Mapping,会员ID统一率从60%提升至95%;开发会员标签计算任务,每天凌晨更新“高价值成长会员”“即将流失会员”等20+核心标签;与运营团队合作,通过A/B测试定义生命周期阈值(如成熟阶段需“近30天消费≥2次+互动≥5次”),并搭建标签可视化界面支持实时查询。
  • 项目成果:平台上线后,会员标签覆盖率从60%提升至95%,运营挽回流失会员的ROI从1.0提升至1.4(+40%),“高价值成长会员”ARPU值同比增长25%;公司会员数量从800万增长至1080万(+35%),超额完成年度目标;我主导的“会员生命周期数据模型”获公司技术创新奖,成为会员运营核心工具。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
奖项荣誉
  • 数据库系统工程师(中级)
  • 2022年度公司项目攻坚奖
  • 2023年度部门优秀技术骨干
自我评价
  • 深耕互联网数据平台开发6年,以业务价值为核心导向,擅长从用户行为、运营场景反推数据架构设计,确保技术与业务增长同频。
  • 主导过亿级数据量平台迭代,形成“高可用+低延迟”系统方法论,习惯结构化拆解复杂问题,平衡性能与成本。
  • 主动搭建业务-技术对齐机制,通过需求前置评审与文档标准化,减少跨团队沟通损耗,推动方案快速落地。
  • 紧跟实时计算、湖仓一体等行业趋势,善于融合新技术优化平台,持续提升数据处理效率与业务支持敏捷性。
试一下,换个颜色
选择配色
使用此模板创建简历
  • 支持电脑端、微信小程序编辑简历
  • 支持一键更换模板,自由调整字距行距
  • 支持微信分享简历给好友查看
  • 支持简历封面、自荐信、自定义简历模块
  • 支持导出为PDF、图片、在线打印、云端保存
该简历模板已内置
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
对话框
提示
说明