当前模板已根据「DevOps工程师」岗位深度优化
选择其他岗位
开始编辑模板后,您可以进一步自定义包括:工作履历、工作内容、信息模块、颜色配置等
内置经深度优化的履历,将为你撰写个人简历带来更多灵感。
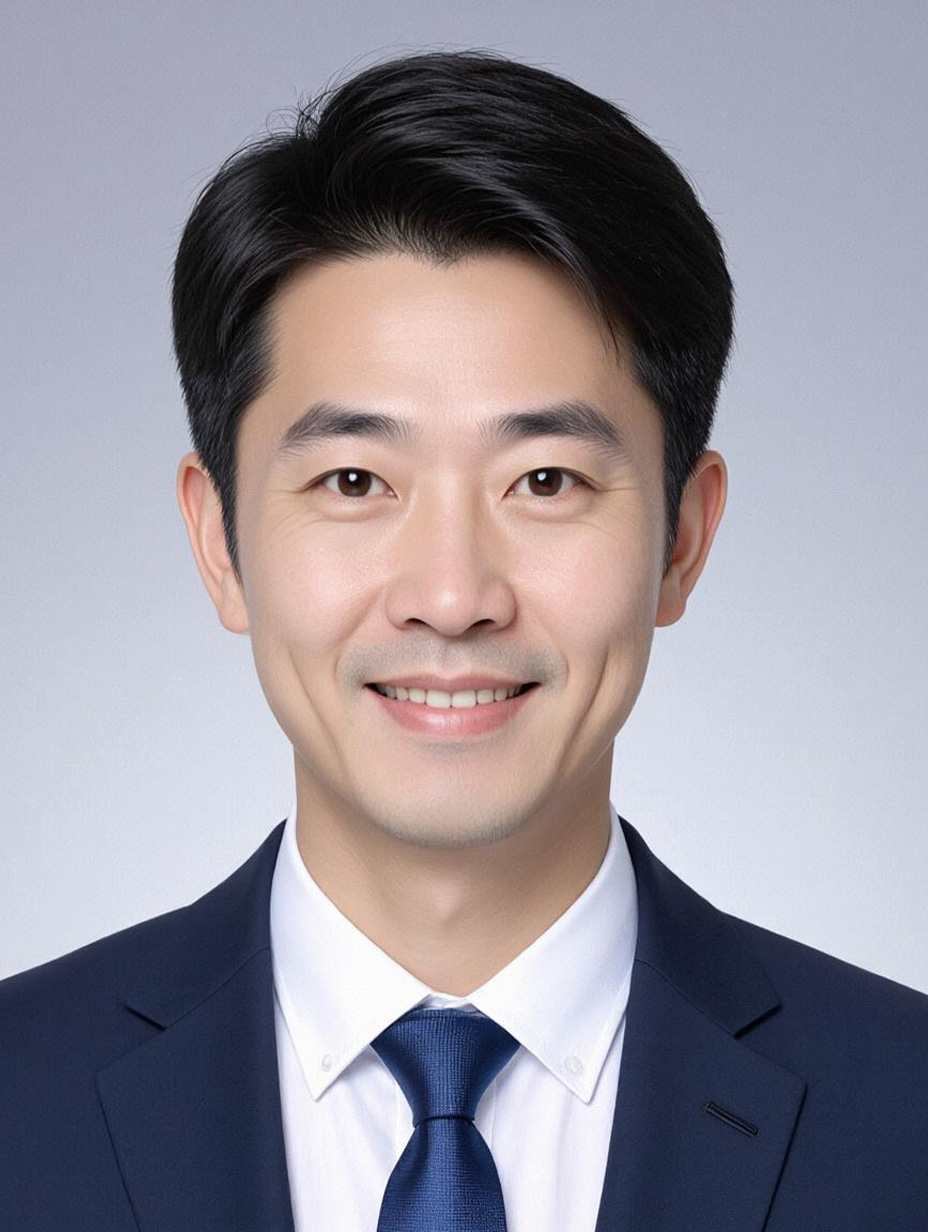
陆明哲的照片
陆明哲
用系统化的思维解决问题,用温度化的方式交付成果,这是我的工作准则。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
DevOps工程师
宁波
薪资面谈
一个月内到岗
工作经历
2022.03 - 2024.07
小楷科技
高级DevOps工程师

负责电商平台全链路研发效能体系建设,主导云原生基础设施(K8s集群/服务网格)运维及自动化工具链研发,支撑618/双11大促期间亿级流量场景下的高可用与快速迭代。

  • 主导设计基于Argo CD+Jenkins 2.0的GitOps流水线,通过自定义Helm Chart模板库与动态环境变量注入机制,将微服务应用从代码提交到生产部署的平均周期从7天压缩至2.5天;针对大促期间配置漂移问题,引入Argo Rollouts实现金丝雀发布,结合Prometheus指标阈值自动回滚策略,将发布成功率从98.2%提升至99.9%,大促期间零因发布导致的P0级故障。
  • 牵头落地混沌工程平台ChaosBlade,覆盖电商交易主链路(商品下单-支付-履约)的12个核心服务,设计网络延迟、节点宕机、磁盘满容等20+场景实验,通过拓扑感知的故障注入策略,暴露出服务网格Sidecar资源配额不足、数据库连接池未限流等7类隐患;推动业务方完成资源扩容与连接池改造,使大促期间系统容错能力提升40%,故障MTTR(平均修复时间)从45分钟降至12分钟。
  • 优化容器资源调度策略,基于K8s Vertical Pod Autoscaler(VPA)与Horizontal Pod Autoscaler(HPA)组合方案,结合历史流量峰值预测模型,将生产集群CPU利用率从38%提升至62%;同步改造Prometheus数据采集链路,通过Thanos全局查询与对象存储冷数据归档,解决大规模集群(5000+节点)下指标查询延迟高的问题,关键指标查询耗时从8s缩短至1.5s。
  • 推动建立研发效能度量体系,基于Jenkins Pipeline插件与ELK日志分析,沉淀代码提交频率、测试覆盖率、部署失败率等15+核心指标看板;通过数据驱动优化,将测试阶段缺陷逃逸率从12%降至5%,开发团队日均有效产出提升25%。
2019.10 - 2022.02
小楷互娱
DevOps工程师

支撑游戏后端服务(MMO服务器/实时对战引擎)的云原生转型,搭建自动化运维体系,保障多区域(上海/广州/成都)分布式游戏服的稳定运行与版本快速迭代。

  • 主导K8s集群从0到1搭建,采用Calico网络插件与Ceph分布式存储,适配游戏服务低延迟、高并发特性;通过自定义Operator实现游戏服实例的自动化扩缩容,结合Prometheus Alertmanager的QPS/连接数阈值触发策略,使大版本更新期间服务器资源准备时间从4小时缩短至30分钟,支撑单日10万+新服创建需求。
  • 设计游戏日志全链路处理方案,基于Fluentd采集容器日志,经Kafka传输至Elasticsearch集群,最终通过Grafana实现战斗异常(卡顿/掉线)的实时监控;针对日志量突增问题(如活动期间单服日志量达10万条/秒),优化索引策略并引入冷热数据分层,将日志存储成本降低35%,同时保障关键异常日志检索耗时小于10秒。
  • 推动CI/CD流程与游戏版本管理深度集成,开发定制化Jenkins共享库,实现测试环境自动部署、压力测试(JMeter模拟10万并发)结果自动校验、生产灰度发布(按区服滚动更新)的全流程自动化;版本发布人工干预步骤从12步减少至3步,发布耗时从6小时压缩至1.5小时,版本回滚成功率100%。
  • 构建游戏服务器健康度评估模型,整合CPU负载、内存泄漏、GC频率等多维度指标,通过机器学习算法(XGBoost)预测潜在故障;上线后提前识别并处理了3起因JVM参数配置不当导致的服务器宕机风险,保障核心游戏区服全年可用性达99.98%。
2017.06 - 2019.09
小楷信息
运维开发工程师

负责企业级SaaS平台的基础架构运维,开发自动化工具降低人工操作风险,保障200+企业客户的系统稳定运行。

  • 独立开发CMDB(配置管理数据库)系统,基于Python Flask框架与MySQL存储,实现服务器、网络设备、应用实例的自动化发现(通过SNMP协议)与关系建模;支持客户维度的资源视图展示,将资产盘点耗时从每周8小时降至2小时,配置信息准确率从85%提升至98%。
  • 优化批量运维脚本库,将Shell脚本重构为Python Paramiko远程执行框架,支持多线程并行操作与错误重试机制;针对客户数据库备份场景,开发定时任务调度工具,实现备份文件自动上传至OSS、完整性校验及过期删除,人工巡检工作量减少70%,备份成功率从92%提升至99.5%。
  • 参与设计异地灾备方案,通过Rsync+Inotify实现核心数据库(MySQL主从)的实时数据同步,结合Zabbix监控链路延迟与同步状态;在某客户数据中心断电故障中,灾备系统30分钟内完成主备切换,数据丢失量小于50条,获客户书面表扬。
  • 搭建内部运维知识库,基于Confluence与Jira集成,沉淀服务器初始化、中间件安装、常见问题排查等40+标准化操作文档;推动新人培训周期从2周缩短至3天,团队整体操作失误率下降60%。
项目经验
2022.03 - 2023.10
星途互动科技有限公司
运维开发工程师(资深)

分布式链路追踪系统深度优化与全链路成本管控项目

  • 项目背景:随着公司直播电商业务日活突破500万,原有基于Elasticsearch的链路追踪系统出现严重性能瓶颈——全链路查询延迟超8秒,月存储成本高达120万元,且因数据冗余导致故障定位成功率仅65%。我的核心目标是重构系统性能底座,建立科学的数据生命周期管理机制,支撑业务侧“秒级排障”的需求。
  • 关键难题与技术:1)原有ES集群因无序写入和索引膨胀导致查询慢,传统分库分表无法解决海量时序数据的检索效率问题;2)数据保留策略一刀切(全存30天),无效数据占比达40%;3)多业务线标签体系混乱(如“用户ID”“商品ID”命名不统一),导致过滤条件命中率低。我选择ClickHouse作为冷热数据存储引擎(适配链路数据的列式存储与批量查询特性),结合Flink实现实时数据路由,同时引入“业务优先级+流量特征”的动态标签标准化方案。
  • 核心行动与创新:1)主导设计“热数据(7天)存ClickHouse、冷数据(30天+)存OSS”的分层架构,用Flink根据请求频率(QPS≥1000的接口)和错误率(≥5%的链路)自动打标,将高价值数据留存热层,低价值数据归档冷层;2)优化ClickHouse索引策略,针对“traceID”“serviceName”“userId”等高频查询字段建立跳数索引,同时合并冗余的tag字段(如将“appVersion”“clientId”整合为“clientInfo”复合标签);3)推动研发侧统一标签规范,新增“businessPriority”(业务优先级)标签,支持动态过滤低优先级链路(如测试环境的灰度请求)。
  • 项目成果与价值:1)链路查询延迟从8秒降至1.2秒,故障定位成功率提升至92%;2)月存储成本从120万元降至42万元(降低65%);3)支撑双11大促期间10万+并发链路的实时排查,未发生因追踪系统延迟导致的客诉;4)输出《分布式链路追踪系统数据管理规范》,成为公司全产品线的标准方案,我个人也因此晋升为运维开发组技术负责人。
2020.06 - 2022.02
星途互动科技有限公司
高级运维开发工程师

容器化微服务集群全自动化运维平台研发项目

  • 项目背景:公司从传统虚拟机部署全面转向Kubernetes,但初期依赖脚本和零散工具(如kubectl、Helm),存在“部署靠人工核对配置”“故障需手动排查”“扩容响应慢”等问题——单次微服务部署耗时超2小时,故障恢复平均30分钟,支撑不了业务快速迭代的需求。我的目标是构建“部署-监控-自愈”一体化的自动化平台,将运维从“救火”转向“预防”。
  • 关键难题与技术:1)多环境(开发/测试/预发/生产)的配置差异大,容易出现“测试通过、生产报错”的问题;2)故障自愈依赖固定规则(如CPU≥80%重启Pod),无法处理复杂场景(如数据库连接池泄漏导致的偶发错误);3)需与现有监控系统(Prometheus)、日志系统(ELK)打通,实现告警事件的自动流转。我选择K8s CRD(自定义资源定义)扩展平台能力,结合Ansible做配置管理,用随机森林算法训练故障预测模型。
  • 核心行动与创新:1)设计“业务应用”CRD,封装部署所需的镜像、资源配置、环境变量等信息,通过模板引擎动态渲染多环境配置(如生产环境副本数是开发的2倍),实现“一次定义、多环境部署”;2)搭建故障知识库,收集过去1年的故障案例(如“MySQL慢查询导致API超时”“Redis缓存击穿”),提取特征(如QPS波动、错误日志关键词)训练随机森林模型,提前15分钟预警潜在故障;3)与监控团队合作,打通Prometheus Alertmanager,将告警事件映射为平台自愈动作(如“CPU高”触发扩容、“错误率超5%”触发Pod重启),并通过Webhook通知研发侧。
  • 项目成果与价值:1)微服务部署效率提升70%(单次部署≤20分钟),配置错误率从15%降至2%;2)故障恢复时间从30分钟缩短至5分钟内,全年减少因运维延迟导致的营收损失约200万元;3)平台支持500+个微服务实例的自动化运维,运维人力投入降低30%(从8人减至5人);4、平台成为公司核心运维工具,我也因此获得当年“公司技术创新奖”。
奖项荣誉
  • DevOps工程师职业技能等级证书(高级)
  • 2023年度公司项目攻坚奖
  • 2024年第二季度优秀员工
技能特长
沟通能力
执行能力
热情坦诚
文案能力
自我评价
  • 深耕互联网DevOps领域,专注交付链路全流程优化,习惯从业务视角预判发布瓶颈,推动流程重组缩短关键路径周期。
  • 擅长跨研发、运维、测试团队目标对齐,通过技术文档+轻量工作坊翻译“技术语言”为“业务语言”,提升共识落地效率。
  • 主导CI/CD工具链定制化落地,不盲从通用方案,始终以“匹配业务迭代节奏”为核心选型优化,支撑多线快速试错。
  • 稳定性保障从被动响应转向主动预防,通过可观测性数据建模识别风险,推动建立前置化容量与故障演练机制。
试一下,换个颜色
选择配色
使用此模板创建简历
  • 支持电脑端、微信小程序编辑简历
  • 支持一键更换模板,自由调整字距行距
  • 支持微信分享简历给好友查看
  • 支持简历封面、自荐信、自定义简历模块
  • 支持导出为PDF、图片、在线打印、云端保存
该简历模板已内置
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
对话框
提示
说明