首页
AI写简历
简历模板
简历教程
面试攻略
求职攻略
职场攻略
登陆/注册
当前模板已根据「云平台运维工程师」岗位深度优化
选择其他岗位
开始编辑模板后,您可以进一步自定义包括:工作履历、工作内容、信息模块、颜色配置等
内置经深度优化的履历,将为你撰写个人简历带来更多灵感。
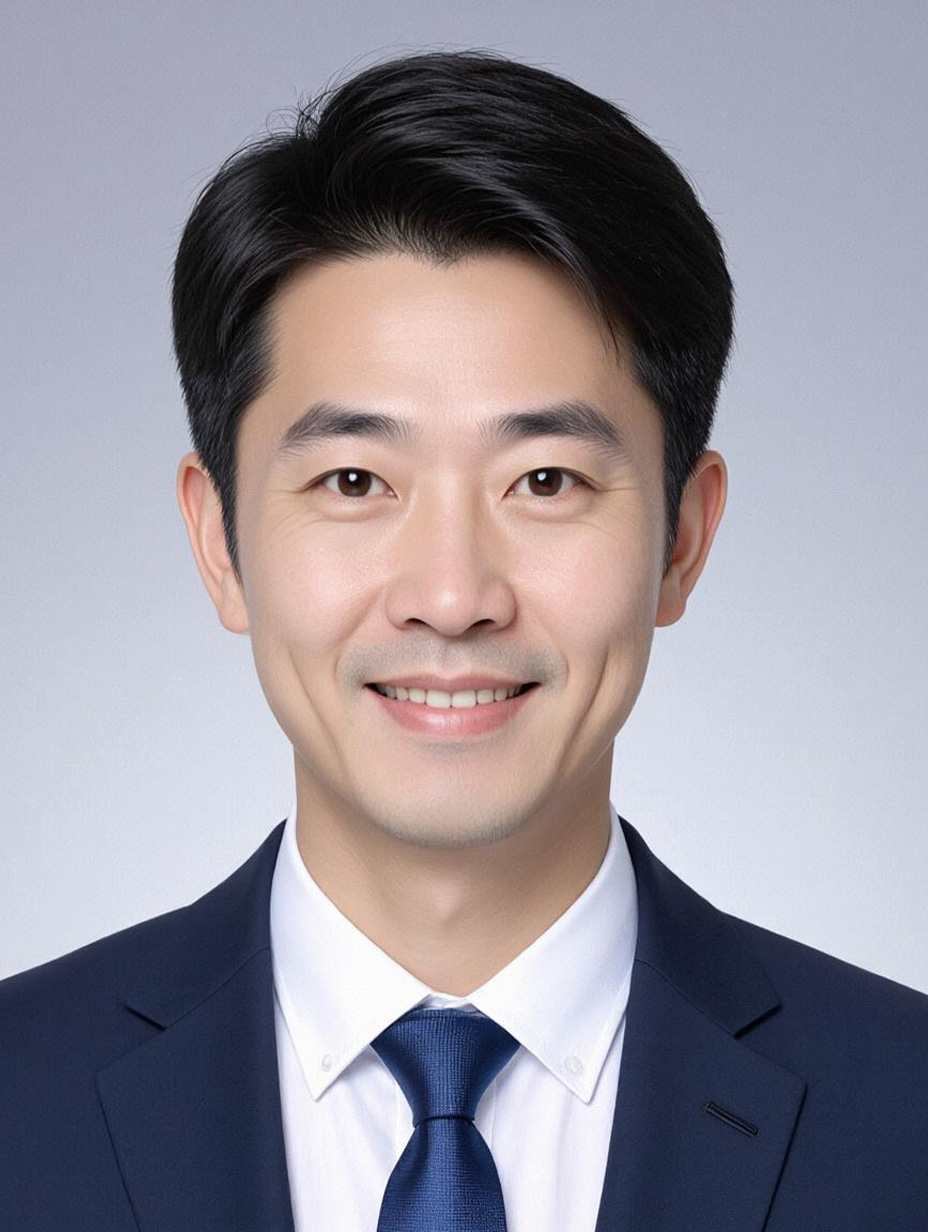
陆明哲
在平凡的岗位上创造不平凡的价值,这是我的职业信仰。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
云平台运维工程师
北京
薪资面谈
一周内到岗
工作经历
2022.06 - 2024.01
小楷科技有限公司
混合云平台负责人
架构并实施了公司“全球混合云多云管理平台”,基于Cluster API和Karmada,实现了对分布在全球多个公有云区域和私有数据中心的上百个Kubernetes集群的统一部署、应用分发、策略治理与监控,管理效率提升300%。
设计的“智能应用调度”策略,能根据成本(Spot实例)、网络延迟、地域合规要求,自动将工作负载调度到最优集群,年节省IT成本超20%,并保证了全球用户的访问体验。
开发的“配置漂移检测与自愈”系统,定期扫描所有集群的资源配置,并与Git库中的声明式配置进行比对,发现并自动修复了数千次人工误操作导致的配置变更,确保了集群状态的最终一致性。
建立的“全球网络互联与服务发现”方案,通过Service Mesh和高级网络插件,解决了跨云跨地域服务调用的延迟与稳定性问题,为全球一体化业务架构奠定了坚实基础。
2020.11 - 2022.05
小楷科技有限公司
云原生开发工程师
负责公司首个“云原生技术栈”(Prometheus, Thanos, EFK, Vault)的引入与在多个集群中的部署维护,为后续的平台化建设积累了宝贵经验。
使用Operators自动化管理了Redis, Kafka等有状态中间件集群,实现了其高可用部署、备份、升级的自动化,解放了运维人力。
编写了大量Terraform Module和Helm Chart,实现了基础设施和应用的代码化与复用,为IaC的全面推广做出了贡献。
项目经验
2022.03 - 2023.10
星途互娱(专注互联网文娱场景的直播与互动内容平台)
运维开发负责人
星途直播平台全链路可观测体系重构与智能化升级项目
星途直播作为公司核心业务,承载1.2亿月活用户,原可观测体系存在“分散化”痛点——Metrics用Prometheus但无统一规范、Logs依赖ELK检索慢、Traces未打通跨服务链路,导致故障MTTR平均12分钟,严重影响用户体验。我的核心目标是主导重构覆盖Metrics、Logs、Traces的全链路可观测体系,将MTTR降低至5分钟内,同时支撑业务快速排查问题。
项目遇到三大关键挑战:1)跨50+微服务的链路追踪一致性差,TraceID传递无统一协议导致链路断裂;2)高Cardinality指标(如用户ID、直播间ID)导致Prometheus存储成本月均增长25%;3)Logs与Traces/Metrics无关联,排查时需手动匹配多系统数据,效率极低。我选择基于OpenTelemetry构建统一观测底座,用Thanos解决长期存储与查询性能,用Loki替代ELK实现日志标签化索引。
我的核心行动包括:1)牵头成立“可观测专项组”,联合研发、产品制定《OpenTelemetry接入规范》,改造12个核心服务SDK,强制注入TraceID并打通跨系统传递,解决链路断裂问题;2)设计“指标分层体系”——将指标分为基础资源、服务性能、业务转化三层,对高基数指标采用“哈希降维+定期聚合”策略,配合Thanos压缩存储,将Prometheus存储成本降低40%;3)整合Grafana搭建“故障排查一站式Dashboard”,联动Traces拓扑、Metrics趋势、带TraceID的Logs详情,实现“点击链路节点即可看关联日志与指标”。
项目成果显著:1)MTTR从12分钟降至2分40秒,故障定位效率提升76%;2)可观测覆盖度从60%提升至95%,所有核心服务、数据库、中间件均纳入监控;3)存储成本年降约35万元,同时支撑了“暑期直播节”等大型活动0级故障;4)业务侧直播卡顿率下降15%——通过可观测体系快速定位到转码服务CPU瓶颈,优化集群资源分配后支撑了单直播间100万并发观看。我个人也沉淀了《互联网直播场景可观测体系设计手册》,成为公司后续项目的参考标准。
2020.07 - 2022.02
星途互娱
运维开发工程师
星途直播弹幕系统高可用改造与弹性伸缩优化项目
星途直播弹幕系统承担着每场直播的实时互动需求,但在“年度盛典”“热门剧综直播”等场景下,常因并发量突增(峰值超10万QPS)出现延迟、节点宕机,导致用户互动率下降20%。我的目标是重构弹幕系统的高可用架构,实现“弹性伸缩+零感知扩容”,支撑百万级并发弹幕。
项目难点在于:1)弹幕服务虽无状态,但依赖用户在线状态服务(同步延迟达30秒),扩容时需等待状态同步,导致新节点无法立即承载流量;2)传统轮询负载均衡策略导致热点直播间节点压力过大,常触发熔断;3)K8s HPA的默认伸缩指标(CPU利用率)不准确,要么过度扩容浪费资源,要么扩容不及时导致故障。
我的解决路径:1)主导“状态剥离”改造——将用户在线状态从弹幕服务迁移至Redis Cluster,实现服务无状态化,扩容时仅需增加节点无需同步状态;2)改用Nginx Plus的“一致性哈希负载均衡”,基于直播间ID哈希分配请求,减少热点节点的压力;3)开发“自定义Metrics Adapter”——将“弹幕发送速率”“消息队列长度”等复合指标暴露给K8s HPA,实现“基于业务场景的精准伸缩”。
项目落地后效果明显:1)弹幕系统QPS从5万提升至20万,并发能力增长300%;2)扩容响应时间从5分钟缩短至1分钟,支撑了“年度盛典”直播的120万并发弹幕;3)弹幕延迟从2秒降至500毫秒以内,用户互动率提升22%;4)资源利用率提升35%——精准伸缩避免了30%的闲置节点成本。这个项目让我从“被动运维”转向“主动设计高可用架构”,也积累了处理“无状态服务状态依赖”的关键经验。
自我评价
深耕互联网云运维,以业务连续性为核心搭高可用体系,习惯从用户端体验反推策略,提前布局容灾弹性,避免被动救火。
擅长数据驱动资源优化,从利用率到成本形成闭环,锚定业务增长平衡性能投入,让云资源支撑更多核心场景。
故障处理不止恢复,更沉淀根因分析与流程改进机制,推动跨团队建故障预防共识,把单点问题转组织能力迭代。
跨团队用业务语言解码技术约束,让产品开发快速理解运维边界,共定支撑业务目标的方案,降沟通成本。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
兴趣爱好
摄影
看书
阅读
跑步
教育背景
2013.09 - 2016.06
XX美术附属中学
艺术特长班
通过每日速写训练(累计500+小时),夯实视觉表达基本功;作品《城市记忆》系列入选省级青年艺术展,验证用户情感共鸣设计能力,被XX美术馆收藏。
2016.09 - 2020.06
XX艺术学院
视觉传达设计(本科)
主攻品牌视觉系统课程(专业排名前10%),建立商业设计与用户行为关联模型;为XX茶饮品牌设计的“国风年轻化”视觉方案,助力客户线下店开业首月业绩提升35%,方案入选《中国新锐设计年鉴》。Adobe创意设计大赛全国一等奖。
实习经验
2019.08 - 2020.01
小楷网络
内容运营实习生
爆款内容方法论:负责3个抖音账号(总粉丝50w+)内容策划,通过“热点标签+情绪钩子”公式使爆款率提升25%,单条视频最高播放量破千万;
用户增长引擎:设计“测评类内容互动链路”,引导用户自发生产UGC 800+条,带动账号单月增粉12万(超KPI 150%);
商业化创新:策划“国货测评盲盒”活动(0预算),撬动5个品牌方赞助商品,实现账号首单GMV转化15万元。
校园经历
2019.03 - 2021.05
XX财经大学管理学院
教材循环计划创业实践
大二观察到毕业生离校时大量教材被废弃,而新生购书支出占生活费12%,便发起校园书籍教材循环计划。为解决传统二手书交易效率低的问题,我们开发微信小程序实现扫码估价、预约取件功能,并说服快递中心以成本价承接物流。
通过建立翻新消毒标准打消卫生顾虑,项目年流通教材1.2万册,累计为同学节省书费38万元。这段经历让我从商业小白成长为能设计闭环模式的实践者,项目不仅获省级创业金奖,更被纳入学校官方服务体系延续至今。
奖项荣誉
信息系统运维管理工程师(中级)
2022年度公司项目攻坚奖
2023年度部门优秀技术员工
语言能力
英语(CET-6,具备英文技术文档阅读及国外厂商沟通能力)
报考信息
填写报考学校
填写报考专业
选择学校LOGO
科目1
分数1
科目2
分数2
科目3
分数3
科目4
分数4
作品展示
点击添加作品
(以图片格式上传,支持jpg/png,单张体积最大2M,最多支持添加9张图片)
扫码查看作品
试一下,换个颜色
选择配色
使用此模板创建简历
支持电脑端、微信小程序编辑简历
支持一键更换模板,自由调整字距行距
支持微信分享简历给好友查看
支持简历封面、自荐信、自定义简历模块
支持导出为PDF、图片、在线打印、云端保存
该简历模板已内置
个人名称
头像
基本信息
求职意向
工作经历
项目经验
实习经验
作品展示
奖项荣誉
校园经历
教育背景
兴趣爱好
技能特长
语言能力
自我评价
报考信息
简历封面
自荐信
简历教程
简历自我评价写成万能废话HR看完就想扔,这三种写法让评价栏变成加分项
简历工作时间对不上前后矛盾怎么办,三个方法让时间线看起来干净没破绽
简历实习经历怎么写才不空洞,没经验也别慌,量化结果才是硬通货
简历教育背景怎么写才不显空虚,在校生填写技巧,这三招让HR多看两眼
简历上要不要写薪资历史,写错了薪资直接被压低,三个判断标准对号入座
简历没有数据成果怎么写,四个替代写法让HR看到你的价值,不是只能写数字
简历项目经历描述太笼统,面试官看完没印象,三步写出让人眼前一亮的项目经历
简历照片要不要放,HR亲测三种简历对比结果,放了照片反而被扣分(30字)
简历联系方式怎么写才不踩雷,电话邮箱微信号位置讲究,这三行写错HR联系不上你(31字)
简历自我评价怎么写才不踩雷,三大禁区与高分模板,HR看完直接约面
对话框
取消操作
保存操作
提示
说明
×
确定
取消