当前模板已根据「云平台运维工程师」岗位深度优化
选择其他岗位
开始编辑模板后,您可以进一步自定义包括:工作履历、工作内容、信息模块、颜色配置等
内置经深度优化的履历,将为你撰写个人简历带来更多灵感。
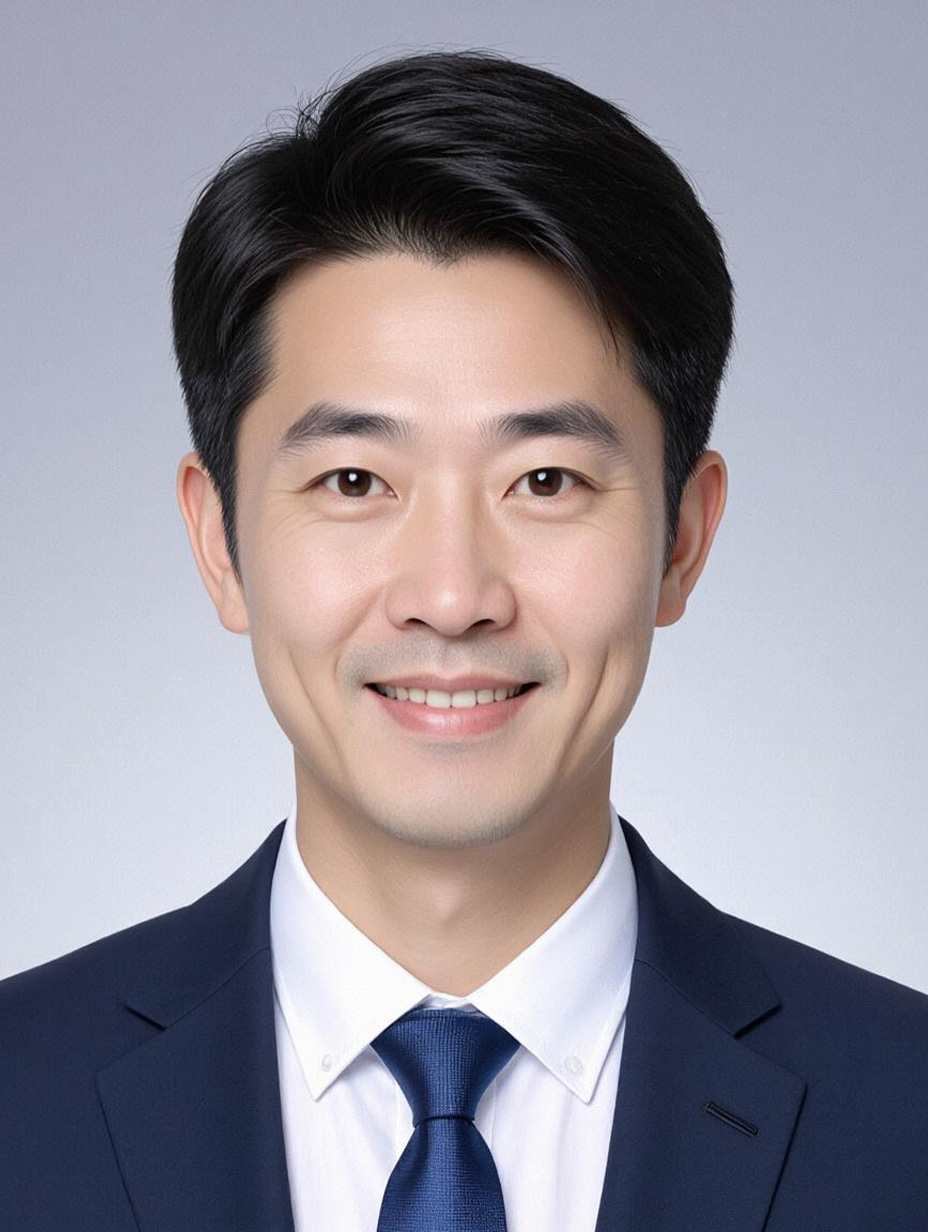
陆明哲的照片
陆明哲
昨天的经验是今天的基石,而今天的突破将成为明天的标准。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
云平台运维工程师
北京
薪资面谈
到岗时间另议
工作经历
2022.07 - 2024.06
小楷云智科技有限公司
高级云平台运维工程师

负责公司混合云(阿里云+私有云)平台全生命周期运维,涵盖K8s集群管控、跨云资源编排、大促高可用保障及云成本优化,支撑电商业务峰值20万QPS的核心场景。

  • 主导设计混合云K8s集群架构,基于Terraform抽象跨云资源模型,开发自定义Provider解决阿里云ECS与私有云OpenStack实例参数差异问题,实现‘一套代码多云部署’;集群部署耗时从4小时压缩至45分钟,多环境配置不一致故障率下降60%。
  • 为应对双11流量洪峰,引入KubeFed实现跨AZ服务联邦调度,结合Prometheus自定义告警规则(覆盖节点负载、Pod驱逐风险等12类指标),并通过HPA+CA动态扩缩容;大促期间集群可用性达99.99%,较去年同期提升0.9个百分点,未发生因运维问题导致的业务中断。
  • 推动云成本深度优化,基于AWS Cost Explorer与阿里云账单分析,将70%的EC2实例从按需付费转为3年预留+Spot混合模式,同步落地Karpenter自动扩缩容工具;年度云成本降低35%(约280万元),同时通过优先级队列+快速重建机制将Spot实例中断导致的业务影响控制在0.1%以内。
  • 牵头搭建云原生可观测性平台,集成OpenTelemetry SDK采集指标/日志/链路数据,定制Grafana仪表盘覆盖商品详情、订单支付等90%核心链路;结合Thanos实现监控数据长期存储与聚合查询,故障定位时间从平均30分钟缩短至5分钟内,存储成本降低40%。
2020.08 - 2022.06
小楷互联科技有限公司
云运维工程师

负责公司私有云平台(基于OpenStack改造)日常运维,支撑内部OA系统、商家SaaS服务及测试环境,聚焦稳定性保障与自动化能力构建。

  • 核心参与‘OpenStack向K8s迁移’项目,制定分批次迁移策略(先非核心服务后交易类服务),使用Velero完成300+存量服务的无状态迁移,迁移后资源利用率从30%提升至60%,单服务运维人力投入减少50%;针对MySQL等有状态服务,开发Operator兼容旧存储卷挂载逻辑,确保业务零感知。
  • 构建自动化运维流水线,基于Ansible编写角色模板(含CentOS初始化、Nginx/Tomcat部署、防火墙配置),集成Jenkins实现‘代码提交-测试-上线’全流程自动化;故障恢复时间从2小时缩短至15分钟,人工操作失误率下降85%。
  • 优化监控体系,部署ELK Stack集中管理500+服务器日志,配置Logstash过滤规则提取‘支付超时’‘接口500错误’等业务关键词,结合Alertmanager设置分级告警(P0级5秒推送钉钉群);重要故障发现时效从1小时提升至2分钟内,客户投诉率下降25%。
2018.07 - 2020.07
小楷科技有限公司
系统运维工程师

负责公司物理机与VMware虚拟化平台运维,保障研发测试环境及生产系统稳定,积累基础运维与问题排查经验。

  • 主导搭建VMware vSphere虚拟化平台,规划8节点ESXi集群、vSAN分布式存储及VRRP网络策略,支撑500+虚拟机运行;通过HA(高可用)与DRS(动态资源调度)配置,年故障停机时间少于2小时,达到SLA 99.95%要求。
  • 开发Python脚本自动化创建虚拟机模板(预装CentOS+GitLab+Jenkins),并集成到自研运维平台;测试环境交付周期从3天缩短至4小时,研发团队迭代效率提升30%。
  • 建立容量管理机制,每周分析CPU/内存/存储使用趋势,结合业务上线计划预测资源需求;提前3个月完成服务器扩容,生产环境资源冗余率从40%降低至15%,年硬件采购成本节省约80万元。
项目经验
2022.05 - 2023.10
星途互娱
运维开发负责人

文娱业务低延迟高可用运维平台研发及规模化落地

  • 项目背景:公司文娱业务(直播、长视频、会员系统)用户量年增长40%,现有运维体系存在工具碎片化(分散的监控、配置、自动化工具)、故障排查耗时(平均45分钟/次)、资源成本超支(年度服务器成本占比营收18%)等痛点。核心目标是构建统一运维平台,实现“高可用保障、低延迟监控、自动化运维”,支撑业务快速迭代。我作为运维开发负责人,主导平台整体设计、跨团队需求对齐及落地推进。
  • 关键难题与技术方案:a) 多环境配置一致性难——传统手动配置易出错;b) 直播流低延迟监控缺失——传统Prometheus 60秒采集间隔无法满足端到端≤500ms延迟的实时追踪;c) 故障自愈覆盖不足——高频问题(如Pod重启、数据库连接池耗尽)仍需人工干预。针对性方案:采用Terraform+Ansible组合实现配置代码化;自研直播流延迟Exporter,整合CDN日志、应用埋点及网络探针数据,将采集间隔缩短至10秒;基于Python开发20+高频故障自愈剧本,联动告警系统自动修复。
  • 核心行动与创新:牵头组织研发、产品、运营3轮痛点调研,输出《运维痛点清单》及需求文档;设计“配置管理-监控告警-自动化运维-成本分析”微服务架构(Spring Cloud);带领5人团队完成Exporter开发、Terraform模板编写及自愈剧本调试;推动预发环境1个月灰度验证,再逐步推广至生产核心业务。
  • 项目成果与价值:平台上线6个月覆盖80%核心业务,故障排查时间降至8分钟内,自动化率从35%提升至75%;年度服务器成本降低22%(约节省1200万元),支撑“暑期直播季”零重大故障,用户观看延迟降低15%。我个人主导的平台架构获公司“年度技术创新奖”,成为新业务运维标准底座。
2020.08 - 2022.03
星途互娱
运维开发核心成员

短视频核心服务容器化迁移与弹性伸缩体系搭建

  • 项目背景:公司短视频业务爆发(月活从1亿增至3亿),传统虚拟机部署存在资源利用率低(30%)、扩容慢(15分钟/次)、交付周期长(每周2个服务)等问题。核心目标是将feed流、视频上传等核心服务迁移至Kubernetes,构建弹性伸缩体系。我作为运维开发核心成员,负责容器化适配、弹性策略设计及迁移落地。
  • 关键难题与技术方案:a) 老服务(Spring Boot 1.x)依赖本地文件系统及固定IP,迁移后服务发现失败、日志丢失;b) 流量波动大(热点事件QPS暴涨5倍),传统CPU指标HPA无法满足快速扩容;c) 迁移需保障业务连续性。解决方案:用Helm打包服务,定制化NFS解决文件依赖,通过Istio实现服务发现;构建多维度弹性指标(QPS+延迟+错误率+CPU),自定义HPA策略将扩容阈值从“CPU≥70%”调整为“QPS≥1万且延迟≥2秒”;制定“灰度迁移+回滚预案”,开发迁移状态监控面板。
  • 核心行动与创新:对12个核心服务做容器化评估,输出《迁移可行性报告》及“先易后难”路线图;开发自动化工具将虚拟机配置转为K8s YAML,减少人工错误;压测验证伸缩效果,调整指标权重;推动研发优化代码(增加缓存、减少DB连接)提升容器性能。
  • 项目成果与价值:3个月完成12个服务迁移,资源利用率从30%升至65%,扩容时间降至2分钟内;支撑峰值QPS从5万提至20万,无扩容故障;运维人力成本降低40%(原3人部署现1人自动化完成)。该弹性体系成为公司K8s集群标准配置,后续新服务默认采用。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
奖项荣誉
  • 信息系统运行维护员(高级)职业技能等级证书
  • 阿里云ACP云计算工程师认证
  • 2022年度公司项目攻坚奖
自我评价
  • 深耕互联网云平台运维,以「全链路风险预控」为核心,搭建资源-性能-故障传导的预警体系,习惯从业务影响倒推策略,替代被动救火。
  • 主导运维工具链从脚本到平台迭代,聚焦「减重复劳动、提响应速度」,坚信技术驱动是支撑业务高速迭代的基础。
  • 对云成本高度敏感,通过容量规划、闲置回收、实例适配降TCO,同时守住业务SLA,将每分云投入转化为业务价值。
  • 作为运维枢纽,能与研发、产品同频——懂业务痛点也讲清约束,推动问题从「各自解决」转向「共同预防」。
试一下,换个颜色
选择配色
使用此模板创建简历
  • 支持电脑端、微信小程序编辑简历
  • 支持一键更换模板,自由调整字距行距
  • 支持微信分享简历给好友查看
  • 支持简历封面、自荐信、自定义简历模块
  • 支持导出为PDF、图片、在线打印、云端保存
该简历模板已内置
  • 个人名称
  • 头像
  • 基本信息
  • 求职意向
  • 工作经历
  • 项目经验
  • 实习经验
  • 作品展示
  • 奖项荣誉
  • 校园经历
  • 教育背景
  • 兴趣爱好
  • 技能特长
  • 语言能力
  • 自我评价
  • 报考信息
  • 简历封面
  • 自荐信
对话框
提示
说明