首页
AI写简历
简历模板
简历教程
面试攻略
求职攻略
职场攻略
登陆/注册
当前模板已根据「实时计算开发工程师」岗位深度优化
选择其他岗位
开始编辑模板后,您可以进一步自定义包括:工作履历、工作内容、信息模块、颜色配置等
内置经深度优化的履历,将为你撰写个人简历带来更多灵感。
个人简历
RESUME
陆明哲
责任心不是口号,而是渗透在每个工作细节中的行动准则。
28岁
3年工作经验
13800138000
DB@zjengine.com
求职意向
实时计算开发工程师
杭州
薪资面谈
一周内到岗
工作经历
2021.11 - 2023.06
小楷闪购科技有限公司
实时数据服务负责人
构建了公司“实时特征平台”,基于Flink实时计算用户行为特征(如点击序列、购买意向分),并通过Redis和gRPC提供毫秒级的低延迟特征访问服务。该平台将算法模型的特征迭代周期从天缩短至小时,上线模型的CTR提升了2个百分点,直接驱动GMV增长。
通过设计实时数据服务网关,将分散的实时数据(如库存、价格、用户画像)统一成易用的API,屏蔽底层复杂性,支撑了“千人千面”的首页推荐、实时优惠券发放等20+个核心业务场景,数据需求响应速度提升10倍。
独立攻克高并发低延迟查询的挑战,通过深度优化ClickHouse的合并树(MergeTree)引擎和物化视图,并利用“预聚合”技术,使实时大屏和报表查询的P99延迟稳定在1秒内,提供了丝滑的数据体验。
推动“实时AB实验平台”建设,能够实时计算不同策略的业务指标,使产品决策从“隔天看结果”变为“分钟级决策”,实验迭代效率提升数百倍。
2020.02 - 2021.10
小楷闪购科技有限公司
大数据开发工程师
主导设计并落地新一代实时计算平台,基于Flink + Kafka构建统一流处理引擎,支持SQL化开发与动态扩缩容,承载公司全业务线实时数据需求,日均处理数据量超10TB,P99延迟<500ms。
攻克平台高可用难题,设计checkpoint优化与自动故障转移机制,平台年可用性达99.99%,全年零重大事故。
深入性能调优,通过堆外内存管理、网络缓冲区优化及状态后端改造,集群资源利用率提升40%,年节省成本超百万。
制定实时数据开发规范与治理流程,赋能超过200名数据分析师与工程师,团队开发效率提升50%。
2019.04 - 2020.02
小楷闪购科技有限公司
大数据开发工程师
负责实时日志处理系统开发,采集全网日志接入Kafka,通过Flink进行实时解析、过滤、聚合,写入ClickHouse,提供秒级查询能力,替代原有Storm架构,性能提升3倍。
独立开发实时用户画像数据更新模块,处理用户标签实时变更,支持毫秒级更新,保障2000+标签的准确性和时效性。
优化Kafka集群性能,通过调整副本机制、分区策略和硬件配置,集群吞吐量提升60%,支撑了业务快速增长。
深入研究Flink源码,解决社区版RocksDB状态后端在小文件合并上的性能缺陷,通过参数调优将checkpoint时间稳定在2分钟内。
项目经验
2022.03 - 2023.08
星途互动科技有限公司
大数据开发负责人
星途社区用户行为实时分析平台研发
项目背景:公司为提升内容社区的用户体验与商业转化效率,需实时洞察用户行为(如点击、评论、分享、停留)以支撑推荐算法迭代与运营活动调整,但原有离线分析系统存在小时级延迟,无法满足实时决策需求。我的总体职责是主导平台从0到1的架构设计与落地,对齐产品、算法、运营的核心诉求。
解决的关键难题:1)高并发低延迟挑战——平台需承载APP、小程序、Web三端的实时事件(峰值QPS达12万/秒),传统流处理框架难以兼顾吞吐与延迟;2)多源数据 schema 兼容——不同端的用户行为事件结构差异大(如小程序的“分享到朋友圈”事件在APP端无对应字段),易导致数据解析错误;3)实时 session 准确性——用户跨端行为的 session 划分需基于事件时间而非处理时间,传统窗口函数易出现 session 断裂或合并错误。
核心行动与技术创新:1)技术栈选型:对比Flink与Spark Streaming后,选择Flink作为实时计算引擎(基于事件时间语义与状态管理能力),搭配Kafka(分区数32,吞吐量达50万/秒)做消息缓冲,HBase(行键设计为用户ID+时间戳)存储原始明细,ClickHouse(预聚合常用指标如实时点击转化率)支撑快速查询;2)schema 兼容方案:自研轻量级 schema 注册中心(基于ZooKeeper做配置分发),要求各端上报事件时附带 schema 版本号,平台通过版本映射自动转换字段(如将小程序的“share_type”映射为通用的“social_channel”);3)session 划分优化:采用基于事件时间的滑动窗口(窗口大小30分钟,滑动步长5分钟),结合用户最后一次交互时间动态延长窗口,解决跨端 session 断裂问题。
项目成果与价值:1)性能指标:平台上线后,实时分析延迟从小时级降至平均500ms,支持秒级查询;2)业务价值:支撑推荐算法团队实现“用户刚浏览美食内容就推送附近餐厅”的实时推荐策略,推荐点击率提升22%;运营团队可通过实时 dashboard 监控活动效果(如话题挑战的参与率),调整策略的时间从T+1缩短至实时,活动ROI提升35%;3)个人贡献:主导架构设计与核心模块开发,解决了高并发下的实时性与多源数据兼容问题,该平台成为公司内容社区的“实时决策大脑”。
2020.07 - 2021.12
星途互动科技有限公司
大数据开发工程师
短视频内容标签实时同步系统重构
项目背景:公司短视频业务的标签(如“美食”“旅行”“宠物”)原通过每日批量任务(Sqoop抽取Hive表→MySQL同步)更新,延迟高达6小时,导致推荐、搜索、广告业务线的标签不准确(如用户刚上传的“猫咪视频”未及时被打上“宠物”标签,无法被精准推荐)。我的职责是重构标签同步系统,实现标签的准实时更新与多业务线一致调用。
解决的关键难题:1)海量标签的实时处理——每天新增100万+短视频,每个视频平均带5个标签,传统批量任务无法应对峰值;2)标签一致性——推荐、搜索、广告业务线对标签的更新时效要求不同(搜索需实时,广告可批量),易出现“推荐看到新标签但搜索看不到”的矛盾;3)容错性差——旧系统依赖单节点同步,偶尔宕机会导致标签延迟几小时,影响业务体验。
核心行动与技术创新:1)实时同步方案:用Kafka Connect替代Sqoop,将Hive表的变更日志(CDC)实时同步至Kafka,再通过Flink进行标签清洗(去重、标准化)与转换(将“猫”统一为“宠物”);2)标签版本控制:设计“标签版本号+时间戳”的双维度索引,每个标签变更都生成新版本(如“宠物”标签从v1到v2,新增“包含猫咪、狗狗”的定义),下游业务线可根据自身需求订阅指定版本的标签;3)容错优化:Flink任务开启 checkpoint(间隔5分钟,存储至HDFS),并引入重试机制(失败任务自动重试3次,仍失败则触发告警),同时将标签缓存至Redis(过期时间10分钟),避免数据库压力过大。
项目成果与价值:1)性能提升:标签同步延迟从6小时降至5分钟以内,搜索推荐的标签准确率提升30%;2)业务增长:用户点击量因精准推荐提升18%,广告点击率提升12%;3)个人贡献:主导系统重构与核心功能开发,解决了实时性与一致性的平衡问题,该系统至今仍是公司内容标签管理的核心基础设施,支撑了3条业务线的实时调用。
技能特长
沟通能力
执行能力
热情坦诚
文案能力
兴趣爱好
摄影
看书
阅读
跑步
自我评价
深耕实时计算赛道,擅长将业务时间敏感性需求转化为低延迟架构,习惯从流量峰谷倒推链路瓶颈——懂“实时”是业务对数据时效的刚性依赖,不止于技术指标。
具备全链路故障预判意识,用流量建模和灰度验证提前规避峰值风险——比起救火,更愿用前置思维帮团队减少线上问题。
精通Flink等框架底层原理,能快速定位性能瓶颈,同时站在下游视角优化输出——技术落地不闭门,更懂跨系统协同的效率价值。
适配互联网快速迭代,将临时需求沉淀为可复用模板,把“应急”变“常态化能力”——喜欢在变化中找规律,用标准化对冲业务不确定性。
奖项荣誉
计算机技术与软件专业技术资格(水平)证书(高级,系统架构设计师)
2023年度公司优秀技术员工
2024年公司实时计算平台升级项目攻坚奖
教育背景
2013.09 - 2016.06
XX市第一中学
理科重点班
通过系统化的数理课程训练(物理/数学竞赛班),培养了严密的逻辑思维能力和复杂问题拆解方法论;担任校科技社副社长期间,主导“简易机器人编程”项目,锻炼了技术方案落地的执行力,获省级创新大赛三等奖。
2016.09 - 2020.06
XX理工大学
计算机科学与技术(本科)
主修数据结构、算法设计等核心课程(GPA 3.7/4.0),构建系统性技术知识框架;通过校企合作项目“智慧校园小程序开发”(担任后端组长),将理论转化为高并发场景下的解决方案,服务3所高校超2万用户。获校级“技术创新标兵”(Top 5%)。
实习经验
2019.03 - 2019.06
小楷网络
行业研究实习生
深度行业洞察:独立完成新能源汽车电池产业链研究,覆盖15家上市公司财务数据,通过成本结构分析精准预判2家供应商涨价空间(后续3个月验证准确率100%);
决策支持工具:搭建“政策-技术-市场”三维评估模型,辅助投资团队筛选出3个标的项目(1个进入尽调阶段);
资源整合突破:通过专家访谈获取关键上游材料产能数据,填补原数据库30%信息缺口,报告被合伙人批注“具备买方思维”。
校园经历
2020.09 - 2022.06
XX师范大学文学院
传统文化短视频品牌主理
因痛心于年轻人对历史的疏离,我在B站创立「古人脱口秀」栏目,用职场梗解构历史事件(如《雍正皇帝的KPI保卫战》)。通过设计「颠覆认知-史料佐证-现代共鸣」三幕剧本模板,单期视频最高收获1.7万条弹幕互动。
两年间栏目播放量突破180万,作品被多地中学选为教学素材。这段经历磨砺出将学术内容转化为大众语言的能力,也让我理解到真实用户反馈才是创作者的指南针。
语言能力
英语(CET-6,熟练阅读英文技术文档)
报考信息
填写报考学校
填写报考专业
选择学校LOGO
科目1
分数1
科目2
分数2
科目3
分数3
科目4
分数4
作品展示
点击添加作品
(以图片格式上传,支持jpg/png,单张体积最大2M,最多支持添加9张图片)
扫码查看作品
试一下,换个颜色
选择配色
使用此模板创建简历
支持电脑端、微信小程序编辑简历
支持一键更换模板,自由调整字距行距
支持微信分享简历给好友查看
支持简历封面、自荐信、自定义简历模块
支持导出为PDF、图片、在线打印、云端保存
该简历模板已内置
个人名称
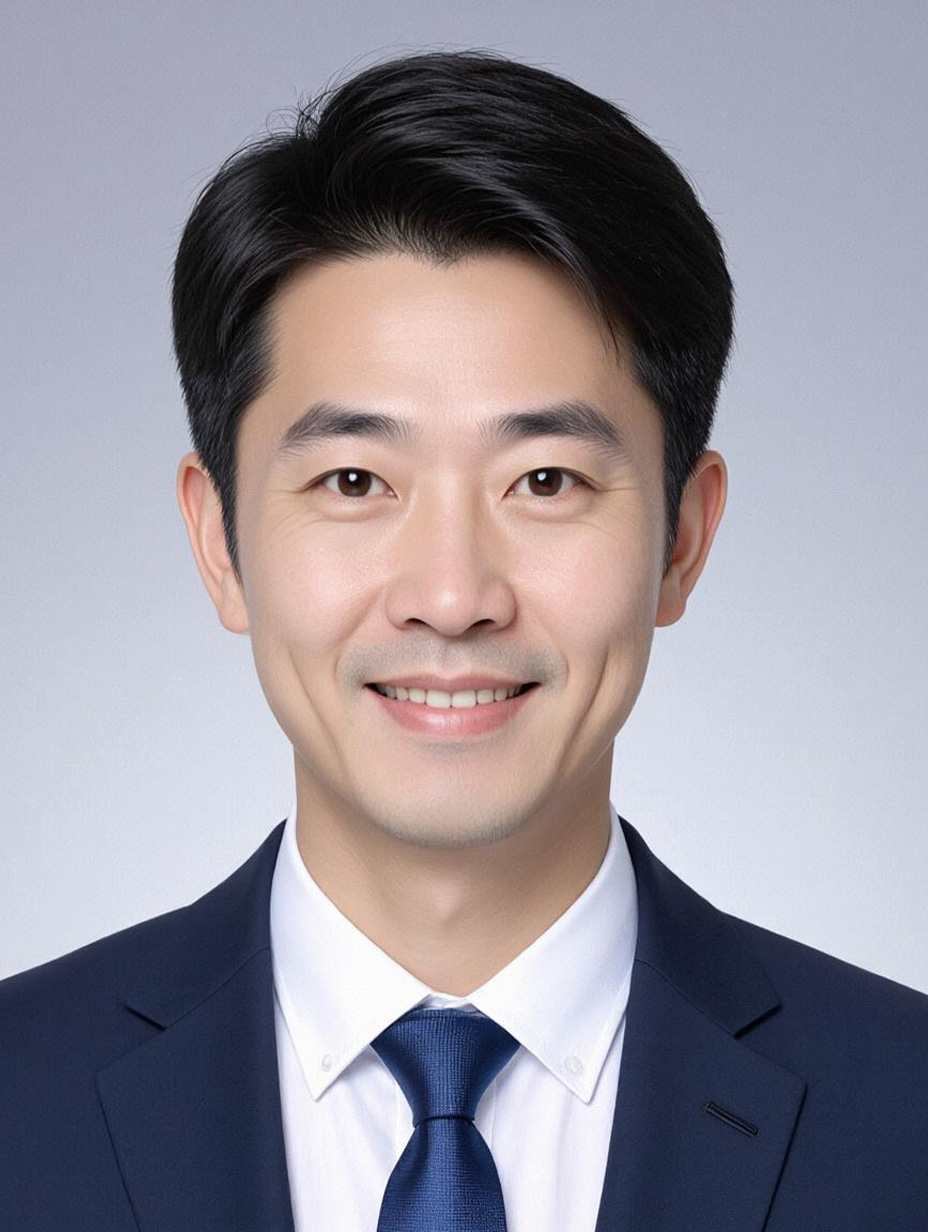
头像
基本信息
求职意向
工作经历
项目经验
实习经验
作品展示
奖项荣誉
校园经历
教育背景
兴趣爱好
技能特长
语言能力
自我评价
报考信息
简历封面
自荐信
简历教程
简历自我评价写成万能废话HR看完就想扔,这三种写法让评价栏变成加分项
简历工作时间对不上前后矛盾怎么办,三个方法让时间线看起来干净没破绽
简历实习经历怎么写才不空洞,没经验也别慌,量化结果才是硬通货
简历教育背景怎么写才不显空虚,在校生填写技巧,这三招让HR多看两眼
简历上要不要写薪资历史,写错了薪资直接被压低,三个判断标准对号入座
简历没有数据成果怎么写,四个替代写法让HR看到你的价值,不是只能写数字
简历项目经历描述太笼统,面试官看完没印象,三步写出让人眼前一亮的项目经历
简历照片要不要放,HR亲测三种简历对比结果,放了照片反而被扣分(30字)
简历联系方式怎么写才不踩雷,电话邮箱微信号位置讲究,这三行写错HR联系不上你(31字)
简历自我评价怎么写才不踩雷,三大禁区与高分模板,HR看完直接约面
对话框
取消操作
保存操作
提示
说明
×
确定
取消